Text Mining 7 - Learning with Limited Labels (3)
Before starting
“Class” 카테고리에 있는 포스팅들은 실제로 수업에서 배운 내용을 정리하려는 목적으로 작성되었다. 이 글은 그 중 Text Mining 과목의 수업을 다룬다.
MMoE in YouTube
저번 글에서 다뤘던 MMoE를 실제로 사용했던 예시를 하나 확인해보자.
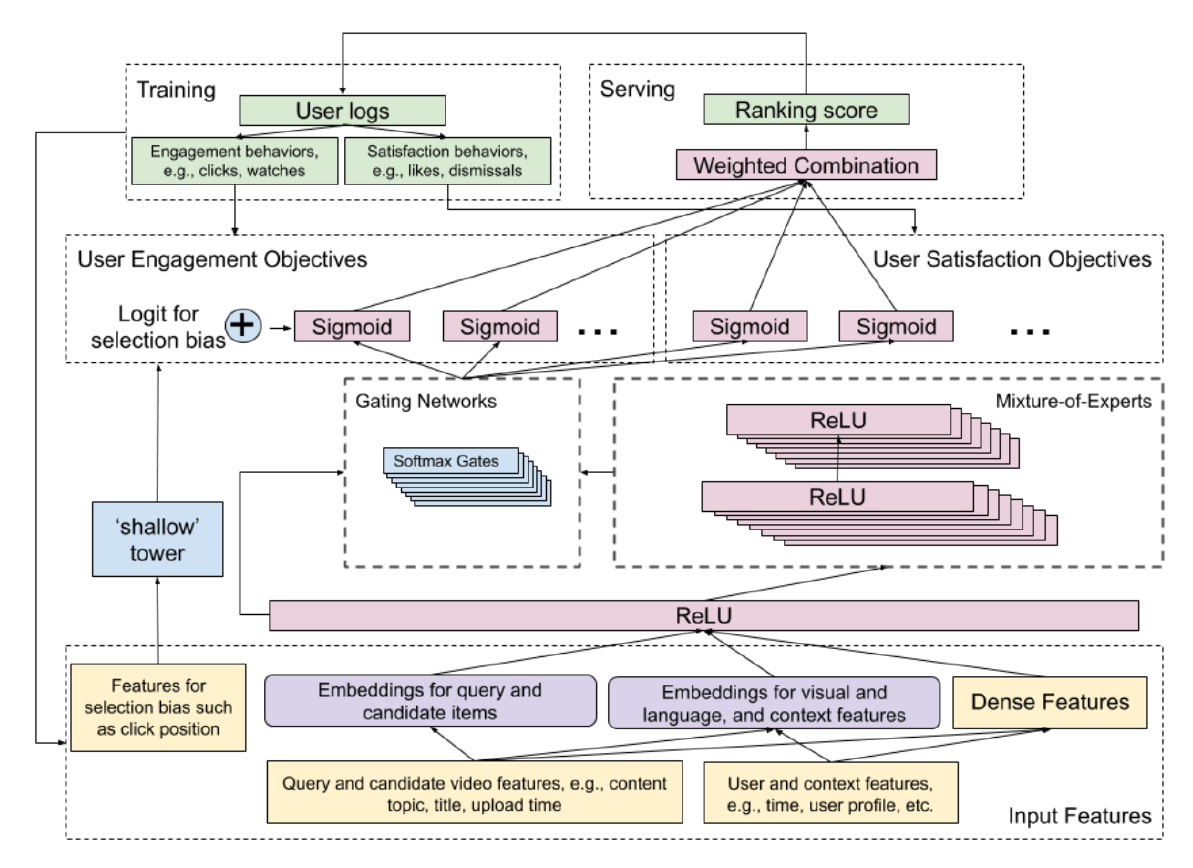
위의 구조는 YouTube에서 2019년도경에 실제로 사용했다고 밝힌 추천 시스템이다. 특정 유저가 지금 보고 있는 동영상을 기반으로, 다음으로 볼 동영상들을 추천 리스트로 제공하는 기능이다.
위의 시스템에서 Input으로 들어오는 것은 유저가 현재 보고 있는 Query Video, 일반적으로 이 Query Video와 같이 보는 Candidate Videos, 그리고 이 유저의 나이, 장소, 시간 등 다른 Feature들이다.
이들 Input을 받아 이 시스템에서는 Engagement Task와 Satisfaction Task라는 두 가지 Objective를 수행한다. Engagement Task는 유저가 얼마나 적극적으로 참여하는지, 즉 Click, Watch, Watch Later 등의 행동을 예측하기 위한 Task이고, Satisfaction Task는 유저의 만족도, 즉 Like, Subscribe, Share 등을 예측하기 위한 Task이다.
이를 해결하기 위한 구조가 위 사진과 같다. 위에 언급된 각각의 요소들을 전부 개별 Sigmoid로 예측하는 Task로 취급하고, 이러한 Task들을 해결하기 위해 MMoE 구조를 채택했음을 확인할 수 있다. 이렇게 각각 예측된 Task들을 종합해서 비공개된 가중치를 사용해 최종적인 Ranking Score를 결정하고, 이 값을 기반으로 유저에게 추천할 동영상 리스트를 예측한다.
이 구조에서 MMoE를 사용한 이유에 대해 구글에서는 Click, Like, Share 등 각각의 세부적인 Task들을 따로 훈련시키기 위한 Label이 매우 부족하기 때문이라고 밝혔다. 이는 모든 종류의 Task에 대해 모든 유저가 전부 다 행동을 취하는 것이 아니기 때문으로, 이 때문에 각 Task 간의 지식을 공유해서 이러한 Label의 희소성을 완화했다. 이 과정에서 각각의 Task 간의 Discrepancy 문제를 해결하기 위해 Full Sharing 대신 MMoE 구조를 채택했다고 한다.
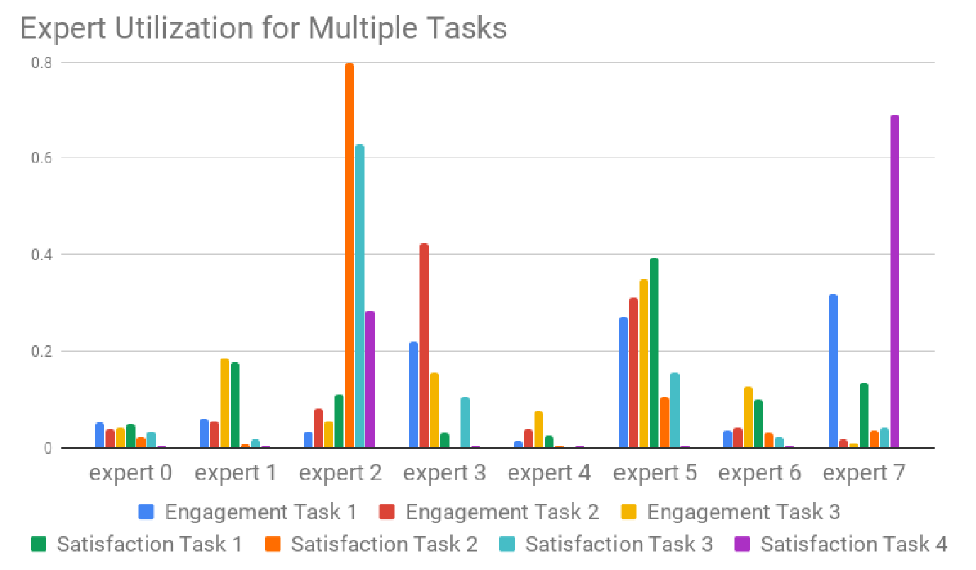
위의 구조를 도입해서 구글에서는 동일한 연산량 및 데이터를 사용했음에도 불구하고 Shared-Bottom 대신 MMoE 구조를 사용했을 때 일관적인 성능 향상이 확인되었다고 밝혔으며, 또한 위 사진과 같이 총 7개의 Task 및 8개의 Expert를 사용했는데 특정 Expert가 특정 Task에 더 많이 점유되어서 사용되는 패턴 또한 잘 드러남을 확인할 수 있다.
Domain Adaptation
이제 Limited Label 문제를 해결하기 위한 마지막 상황을 알아보자. Labeled Data와 Unlabeled Data가 서로 다른 분포에서 왔다면 어떻게 대처해야 할까?
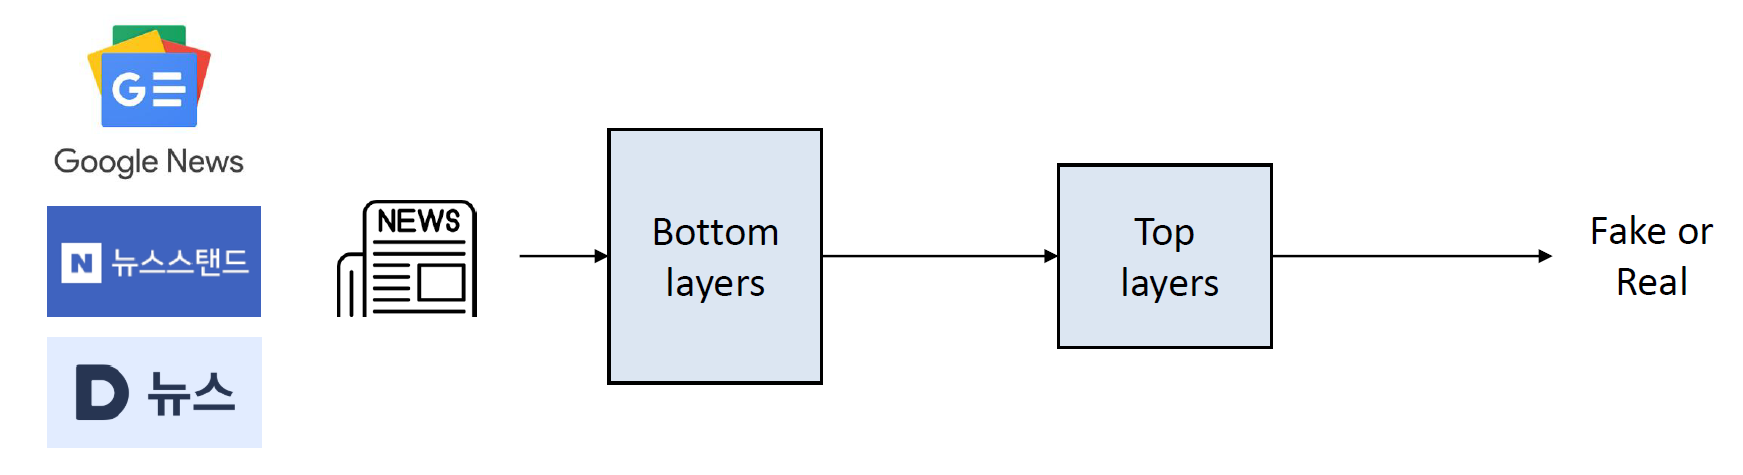
위 사진은 Fake News Detection System을 다루고 있다. 이와 같이 방대한 뉴스 데이터가 주어지게 되고, 이 뉴스가 Fake인지 Real인지를 구분하는 문제를 풀어야 한다고 하자. 이는 일반적인 Binary Classification 문제이므로, 충분한 뉴스 데이터와 Fake/Real Label이 주어진다면 쉽게 학습시킬 수 있다.
그런데 실제로는 이 뉴스 데이터는 전부 하나의 분포라고 가정할 수 없다. 뉴스에서 다루는 주제마다 서로 다른 용어, 이야기, 문체 등을 다루기 때문에 주제별로 서로 다른 분포를 이룬다고 가정해야 한다. 심지어 새로운 주제가 발생할 수도 있으며 이는 기존까지의 모든 데이터와는 다른 분포를 가지기 때문에 모든 뉴스 데이터에 대한 Label을 확보하는 것은 사실상 불가능하다.
이러한 문제를 Domain Adaptation이라고 부른다. 문제를 간소화해서 다음과 같이 두 개의 분포를 생각해보자.
\[D_S=\lbrace(x_i^S,y_i^S)\rbrace_{i=1}^n\quad\text{from}\,P_S(x,y)\] \[D_T=\lbrace x_i^T\rbrace_{i=1}^m\quad\text{from}\,P_T(x,y)\]즉, Source Domain $D_S$는 Labeled Data가 존재하며, Target Domain $D_T$는 Unlabeled Data만 존재하는 상황이다. 이 상황에서 전체 데이터에 대한 모델을 학습시키려고 해도 우리가 아는 것은 Source Domain의 데이터뿐이므로 Loss 함수는 아래와 같은 형태가 될 것이다.
\[\min_\theta\mathbb{E}_{(x,y)\sim P_S(x,y)}\left[L(f_\theta(x),y)\right]\approx\dfrac{1}{n}\sum_{i=1}^n L(f_\theta(x_i^S),y_i^S)\]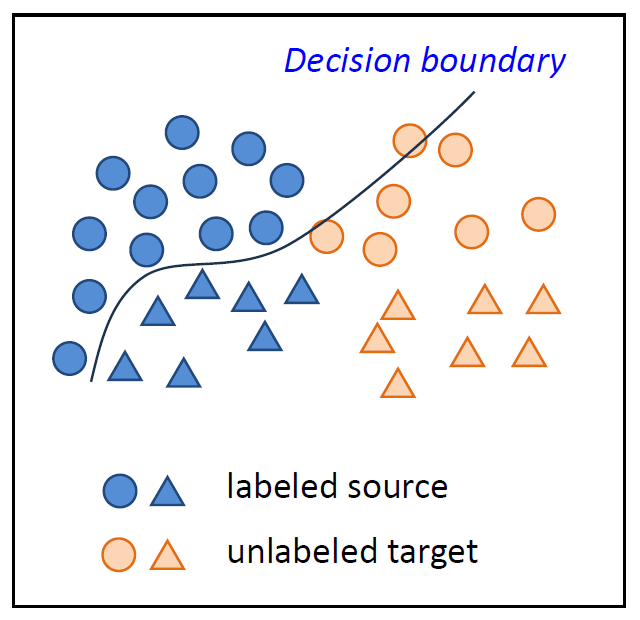
이 Loss는 당연히 Target Domain의 데이터는 전혀 고려하지 못하기 때문에 위 사진과 같이 모든 데이터에 대해선 일관된 성능을 보장할 수 없다. Semi-supervised Learning을 고려할 수는 있겠으나 SSL에서 가정하는 상황과는 달리 아예 다른 분포를 가정하므로 SSL도 그리 좋은 해결책이 되지 못한다.
이러한 Domain Adaptation 문제를 해결하기 위해서는 먼저 아래와 같은 Covariance Shift Assumption이 필요하다.
\[P_S(y\vert x)=P_T(y \vert x)\]즉, 두 Domain이 아주 무관하지 않고 어느 정도의 Shared Rule이, 즉 Common Decision Pattern이 존재한다는 가정이다. Fake News Detection 문제를 예시로 들면 Topic에 상관없이 Fake News가 공통적으로 보이는 특징이 존재한다는 것이다. 이러한 가정이 언제나 성립한다고 보장하지는 못하지만, 대부분의 경우에 대해선 합리적으로 동작하므로 아래 논의에서도 이 Assumption이 성립된다는 전제 하에 진행한다.
Data Reweighting
Domain Adaptation 문제를 해결하기 위한 가장 직관적인 방법은 Data Reweighting이다. Data Reweighting을 한마디로 설명하면 Source Domain에 존재하는 각각의 데이터가 Target Domain을 이해하는 데 얼마나 중요한지를 측정한 후, 그 중요도를 기반으로 선별적으로 반영하는 방법이다.
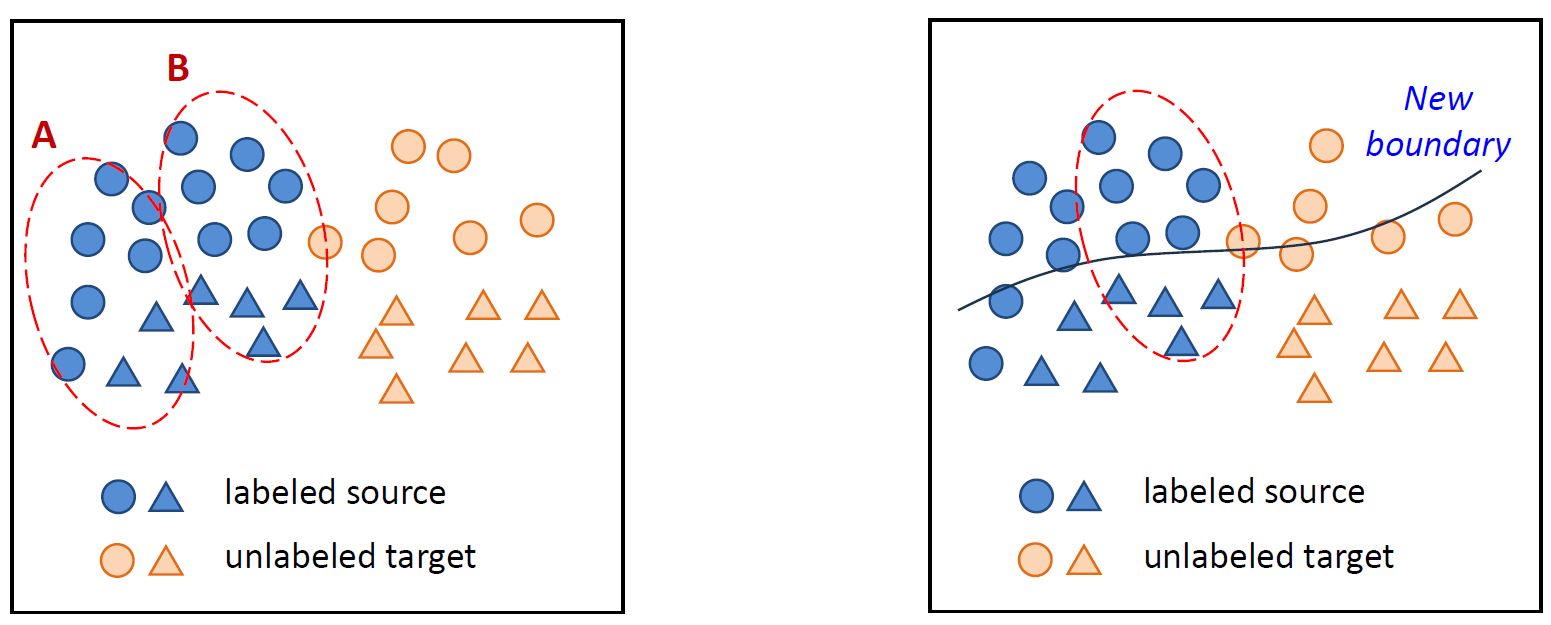
즉 위의 사진과 같이 Source Domain의 데이터 중 Target Domain을 이해하는 데에 더 중요한 데이터는 B에 해당하므로, B에 보다 더 높은 가중치를 둬서 학습을 시키는 것이다. 이렇게 형성된 Decision Boundary는 Source Domain에 대해서는 어느 정도 성능 손실이 있지만 Target Domain까지 포함한 일반화 성능은 더 나은 결과를 기대할 수 있다.
그러면 이제 Source Domain의 어느 데이터가 Target Domain을 이해하는 데에 더 중요한지 알 수 있는 방법을 알아야 한다. 이를 해결하기 위해 목표를 먼저 정의해보자. 최종적인 목표는 Target Domain에서의 Loss를 최소화하는 것이므로, \(\mathbb{E}_{(x,y)\sim P_T(x,y)}\left[L(f_\theta(x),y)\right]\)를 최소화시키면 된다. 이 값은 다음과 같이 정리할 수 있다.
\[\begin{aligned} \mathbb{E}_{(x,y)\sim P_T(x,y)}\left[L(f_\theta(x),y)\right]&=\int P_T(x,y)L(f_\theta(x),y)\,dxdy \\ &=\int\dfrac{P_T(x,y)}{P_S(x,y)}P_S(x,y)L(f_\theta(x),y)\,dxdy \\ &=\mathbb{E}_{(x,y)\sim P_S(x,y)}\left[\dfrac{P_T(x,y)}{P_S(x,y)}L(f_\theta(x),y)\right] \\ &\approx\mathbb{E}_{(x,y)\sim P_S(x,y)}\left[\dfrac{P_T(x)}{P_S(x)}L(f_\theta(x),y)\right] \\ &\approx\dfrac{1}{n}\sum_{i=1}^n w_iL(f_\theta(x_i^S),y_i^S),\quad w_i=\dfrac{P_T(x_i^S)}{P_S(x_i^S)} \end{aligned}\]대부분은 다 정의 그대로 사용해서 유도했지만, $\dfrac{P_T(x,y)}{P_S(x,y)}\approx\dfrac{P_T(x)}{P_S(x)}$는 위에서 언급한 Common Decision Pattern Assumption에서 유도된 근사이다. 다음과 같이 유도할 수 있다.
\[\begin{aligned} \dfrac{P_T(x,y)}{P_S(x,y)}&=\dfrac{P_T(y\vert x)P_T(x)}{P_S(y\vert x)P_S(x)} \\ &=\dfrac{P_T(y\vert x)}{P_S(y\vert x)}\cdot\dfrac{P_T(x)}{P_S(x)} \\ &\approx\dfrac{P_T(x)}{P_S(x)} \end{aligned}\]여기까지 유도된 결과를 생각해보면, 결국 Target Domain에서의 Loss를 최소화시키기 위해서는 각 Source Domain에서의 각 데이터에 대한 가중치 $w_i=\dfrac{P_T(x_i^S)}{P_S(x_i^S)}$가 추가된 Source Domain에서의 Loss와 동일하다. 이 $w_i$를 Importance Weight라고 부르는데, 이는 Bayes Rule($P(x\vert D)=\dfrac{P(D\vert x)P(x)}{P(D)}$)을 사용해 다음과 같이 유도할 수 있다.
\[\begin{aligned} w_i&=\dfrac{P_T(x)}{P_S(x)} \\ &=\dfrac{P(x\vert D=\text{target})}{P(x\vert D=\text{source})} \\ &=\dfrac{P(D=\text{target}\vert x)P(D=\text{source})}{P(D=\text{source}\vert x)P(D=\text{target})} \\ &\propto\dfrac{P(D=\text{target}\vert x)}{P(D=\text{source}\vert x)} \end{aligned}\]여기서 $\dfrac{P(D=\text{source})}{P(D=\text{target})}$은 상수이므로 무시가 가능하다. 그러면 최종적으로 남는 항은 다음과 같다.
\[w_i=\dfrac{P_T(x_i^S)}{P_S(x_i^S)}\propto\dfrac{P(D=\text{target}\vert x)}{P(D=\text{source}\vert x)}\]이 항은 데이터 $x$가 Target Domain에 속할 확률과 Source Domain에 속할 확률을 각각 구해서 계산할 수 있다. 즉, Fake News를 구분하려는 원래의 목적에 더해서, Domain Classifier 모델을 하나 더 학습시켜서 주어진 데이터가 Source Domain인지 Target Domain인지를 구분하게 하면 된다.
이 Domain Classifier 모델에게 필요한 Label은 데이터의 출처이지 원래 문제의 Label이 아니므로, 여기서는 아래와 같은 Binary Cross-Entropy Loss를 활용해 원 문제에서의 Unlabeled Data도 그대로 데이터로 활용할 수 있다.
\[\mathcal{L}_{\text{domain}}(\phi)=-\sum_{i=1}^n\log P_\phi(D=\text{source}\vert x_i^S)-\sum_{i=1}^m\log P_\phi(D=\text{target}\vert x_i^T)\]그렇기 때문에 이 Domain Classifier는 풍부한 Unlabeled Data를 온전히 활용할 수 있으며, 이 정보를 활용해서 원래 풀려고 한 Domain Adaptation 문제까지 해결할 수 있다.
그러나 Data Reweighting은 결국 별도의 가중치를 추가할 뿐, Source Data만 학습에 사용하므로 그렇게 효율적인 방법은 아니다. 또한 이 효율은 Source Domain과 Target Domain의 분포가 얼마 겹쳐 있는지에 따라 달라지게 된다. 즉, 두 Feature space가 잘 Aligned 되어야 한다.
하지만 데이터 자체를 변경하는 방식이 아니기 때문에 Source Domain과 Target Domain의 분포가 그리 가깝지 않으면 Data Reweighting만으로는 해결이 불가능하다.
Adversarial Learning
위에서 보았듯 Data Reweighting은 두 Domain이 가능한 한 많이 겹쳐져 있을수록 유리한데, 정작 Data Reweighting 자체만으론 이 Domain들에 대한 직접적인 변경이 불가능하다. 이 Align 문제를 해결하기 위한 방법 중 하나가 Adversarial Learning이다.
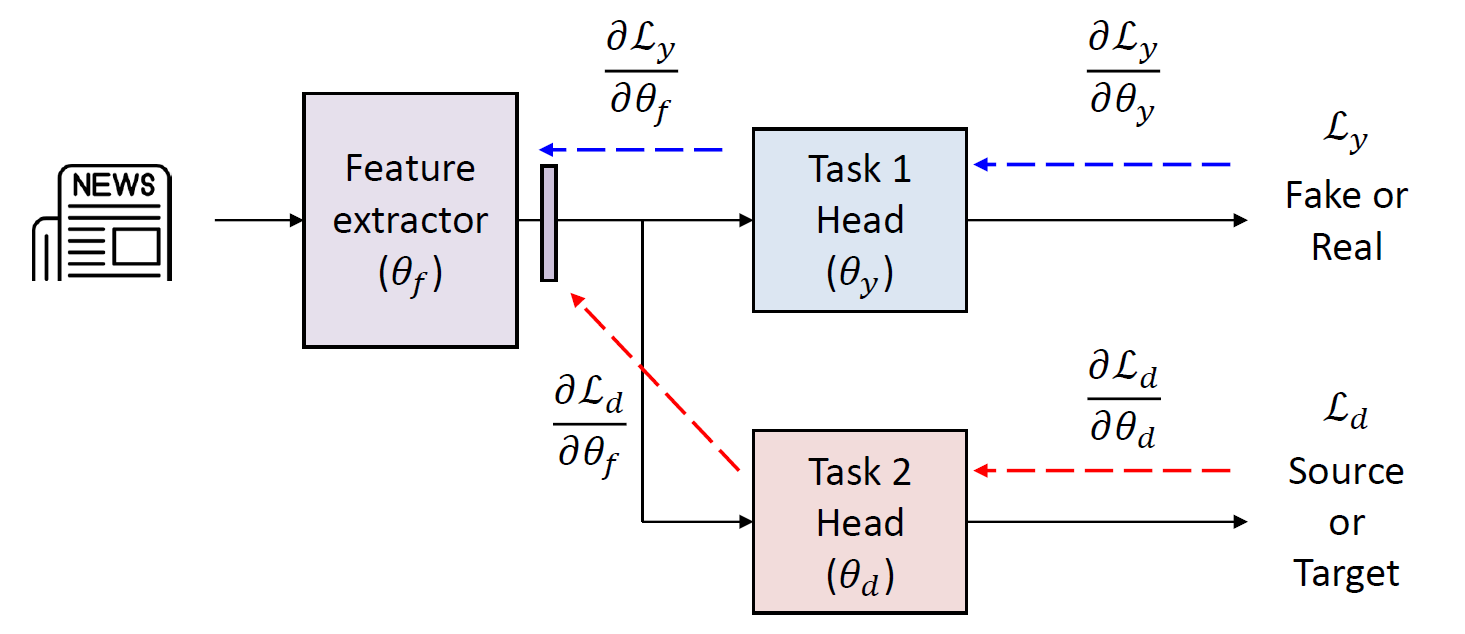
여태까지의 방법을 종합해서, Fake News Detection 문제를 풀기 위해 위와 같이 Source or Target Task를 수행하는 Head를 하나 더 붙이고, 이것을 Multi-task Learning 방법을 사용해서 학습시킨다고 생각해보자.
이렇게 될 경우 위의 Shared Network, 즉 Feature Extractor는 Fake와 Real 뉴스를 구분할 수 있는 정보, 그리고 Source와 Target을 구분할 수 있는 정보를 Feature에 모두 담고 있을 것이다. 그리고 이 모델이 잘 훈련되었다면, 각각의 Task에 대해 이들 두 정보를 잘 구분할 수 있게 된다. 이를 Feature Space에서 생각해보면 각각의 Task에 대해, 각 Class에 대한 Feature Space 분포가 서로 멀어지는 방향으로 학습한다는 의미이다.
이는 Fake/Real을 구분하는 Task에서는 필요한 능력이지만, Source/Target을 구분하는 Task에서는 정확히 우리가 원하는 방향의 정반대로 동작하는 셈이다.
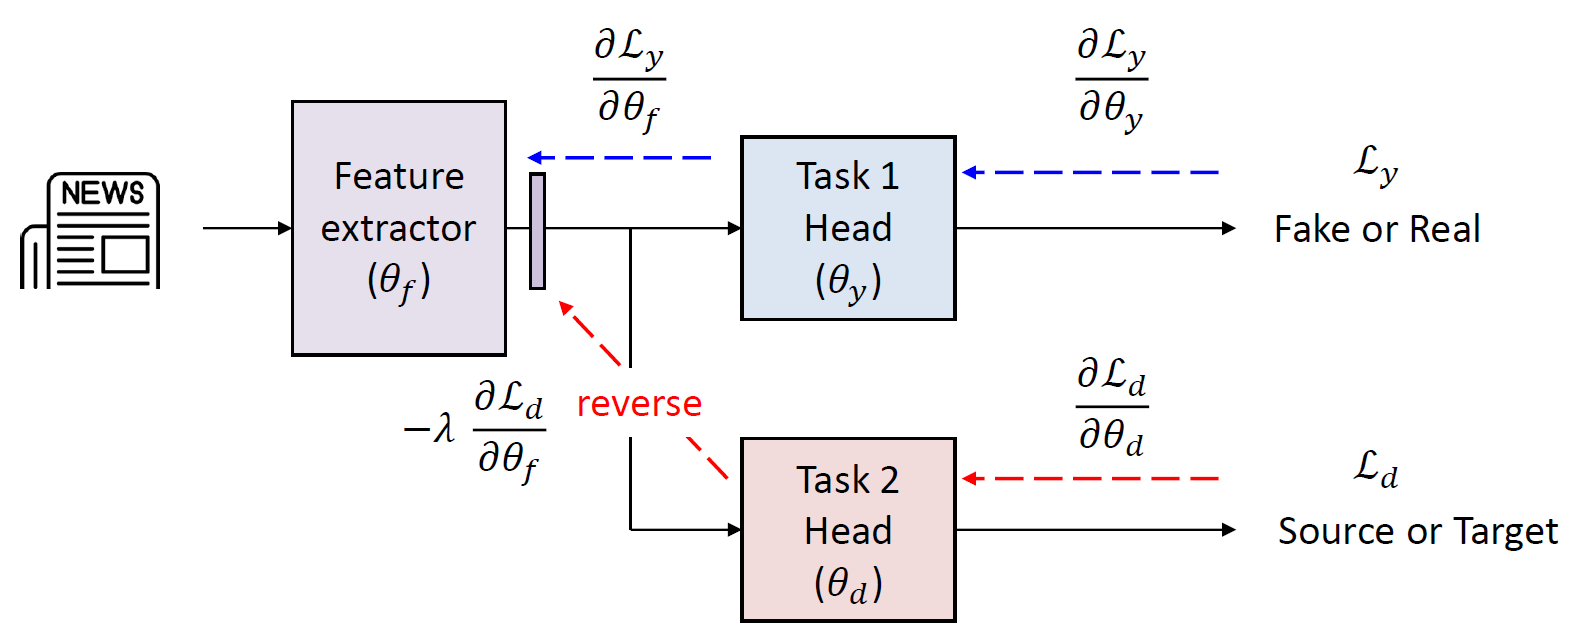
그렇기 때문에 Source/Target을 구분하는 Task의 Graident의 부호를 뒤집어서 Feature Extractor에 전달한다. 이 기법을 Gradient Reversal Layer(GRL)이라고 한다. 이러면 Feature Extractor는 점점 더 Source와 Target을 구분하는 Feature를 겹쳐지는 형태로 학습하게 되어 위에서 다뤘던 Data Reweighting 등의 방법을 잘 적용할 수 있게 된다. 이 때 $\lambda$는 그 Gradient Reversal의 효과를 조절하는 Hyperparameter로 두게 된다.
이를 통해 Domain Classifier를 의도적으로 반대 방향으로 학습시켜 Domain을 구별하기 어렵게 만들고, 이로 인해 Feature Extractor에서 생성되는 Feature는 점점 더 Domain과 무관한 정보들만 담게 되어, 궁극적으로 Fake/Real을 구분하는 Task 역시 이러한 Domain-Invariant Feature를 기반으로 학습하게 된다.
이는 곧 도메인과 무관한 Feature를 사용해서 구별하도록 유도하는 장치가 되기 때문에, Unlabeled Data만 존재하는 Domain에 대해서도 동일한 작동을 기대할 수 있게 된다.
Graident Reversal Layer를 적용했을 때의 Objective Function은 다음과 같은 형태가 된다.
\[\min_{\theta_f,\theta_y}\max_{\theta_d}\mathcal{L}_y(\theta_f,\theta_y)-\lambda\mathcal{L}_d(\theta_f,\theta_d)\]여기서 $\lambda$는 위에서 언급했던 Hyperparameter, $\theta_f$, $\theta_y$, $\theta_d$는 각각 Feature Extractor, Label Classifier, Domain Classifier의 Parameter를 의미한다. 즉, $\mathcal{L}_y$는 Label Classification Loss를, $\mathcal{L}_d$는 Domain Classification Loss를 의미하게 된다. Domain Classification Loss에 Reversal이 걸리므로 이런 식으로 두 Loss를 빼는 형태의 Objective Function을 얻을 수 있다.
이러한 형태는 생각해보면 Feature Extractor와 Domain Classifier가 서로 반대 방향으로 학습되기 때문에 Adversarial Learning이라고 불린다. 여담으로 생성 모델에도 이와 비슷한 접근을 취하는 GAN이라는 모델이 있는데, 실제로 Adversarial Learning은 GAN의 영향을 받아서 고안된 방법이라고 한다.
Adversarial Learning을 이용한 학습은 복잡해보이지만 알고리즘을 따져보면 생각보다 간단함을 알 수 있다. 전체적인 알고리즘은 크게 다음의 과정을 거친다.
- $\theta_f$, $\theta_y$, $\theta_d$를 초기화한다.
- 수렴할 때까지 아래의 과정을 반복한다.
- $(x^S,y^S)\in D_S$, $x^T\in D_T$를 무작위로 샘플링한다.
- $\mathcal{L}_y(\theta_f,\theta_y)$, $\mathcal{L}_d(\theta_f,\theta_d)$를 계산한다.
- 다음과 같이 각 Parameter를 업데이트한다.
그러면 굳이 Gradient Reversal을 해야 하는 이유가 무엇일까? 그냥 Domain Classifier를 위한 Loss를 만든 후, 이것을 Maximize하는 방향으로 학습하면 되지 않을까? 그러나 그 방식은 그 Loss에 영향을 받는 모든 Gradient의 부호가 뒤집히게 된다. 우리가 원하는 것은 Feature Extractor는 제대로 학습하고, Domain Classifier만 반대로 학습하는 것이기 때문에 위와 같은 방식으로는 제대로 학습되지 않는다.
마지막으로, 이러한 Adversarial Learning은 두 Domain을 단순히 겹치게 하는 것에만 관심을 갖기 때문에, 각 Domain의 구조를 보존할 것이라는 보장을 할 수 없다. 그렇기 때문에 Domain은 잘 겹쳐졌더라도 그 안의 Class정보가 섞여버리는 문제가 발생할 수 있고, 따라서 이 문제를 해결하기 위해 보다 더 정교한 Domain Adaptation 방법들이 연구되고 있다고 한다.