Text Mining 1 - Sparse Representation
Before starting
“Class” 카테고리에 있는 포스팅들은 실제로 수업에서 배운 내용을 정리하려는 목적으로 작성되었다. 이 글은 그 중 Text Mining 과목의 수업을 다룬다.
Representing texts with vectors
쇼핑몰을 운영한다고 가정해보자. 각각의 상품들의 이름, 설명, 태그 등은 물론이고 고객의 검색 등도 전부 자연어로 이루어져 있다. 당연하지만 이렇게 자연어로 표현된 다양한 정보들은 기계나 모델이 바로 이해하긴 어려워서 이들이 이해하기 쉬운 형태, 즉 수학적인 처리가 가능한 형태로 변환해야 한다. 그렇기 때문에 텍스트 마이닝은 자연어를 벡터로 변환하는 것에서 시작한다.
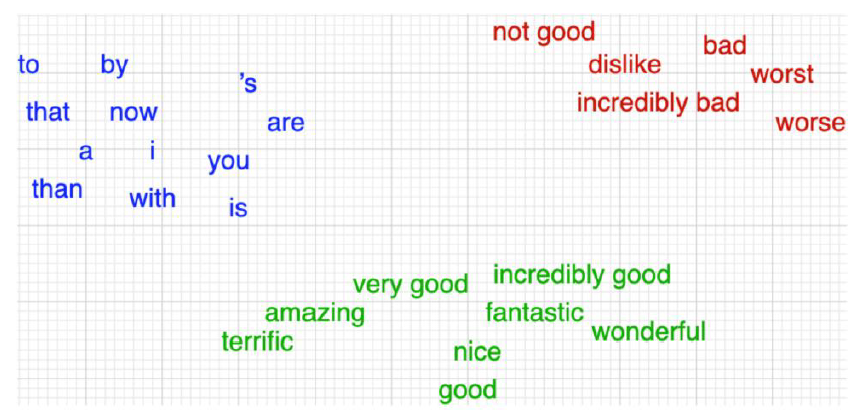
물론 아무 벡터로 변환되기만 하면 안되고, 위 사진과 같이 의미적으로 유사한 단어들은 가깝게 위치하도록 변환되는 것이 이상적이다.
그러면 어떻게 자연어를 벡터로 변환할 수 있을까? 이는 크게 Sparse Representation과 Dense Representation의 2가지 방법으로 나눌 수 있다. 이 중 이번에 다룰 Sparse Representation은 보다 간단한 방법으로써 변환될 벡터의 축마다 각 단어를 의미하는 방식을 의미한다.
Bag-of-words (BoW)
이러한 Sparse Representation 중에서도 가장 먼저 생각할 수 있는 방법이 Bag-of-words (BoW)이다. BoW는 말 그대로 단어들의 가방을 의미한다. 즉, Document에 등장하는 단어들의 순서나 문법적 구조는 무시하고, 단순히 등장한 단어들의 집합과 횟수만으로 Document를 표현하는 방법이다.
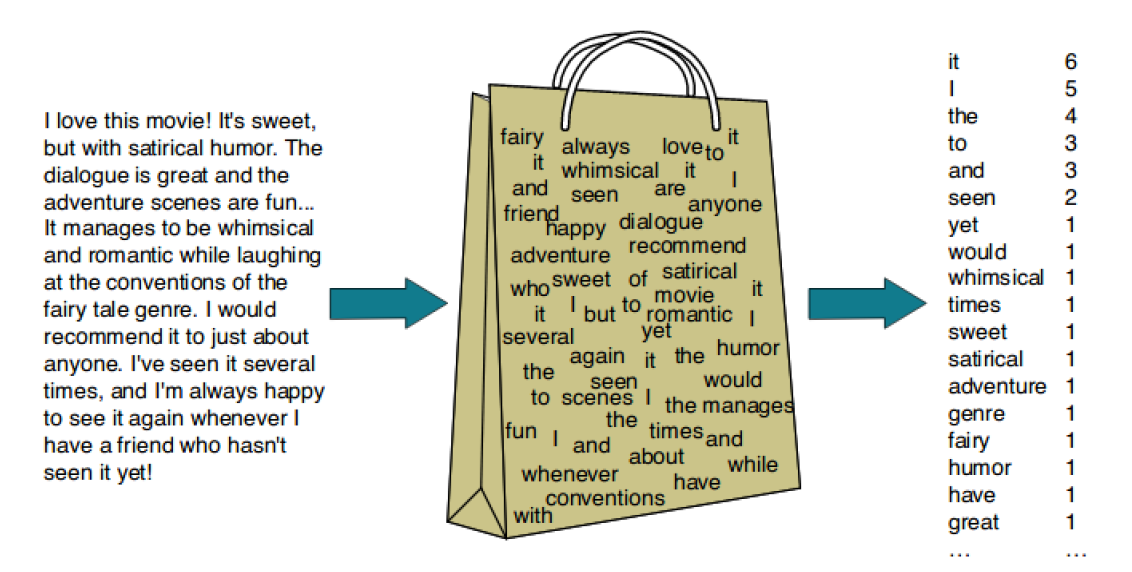
BoW는 굉장히 간단하고 직관적인 방법인만큼 한계도 명확하다. 대표적으로 단어의 순서 정보와 맥락이 전부 소실되어버리는 문제가 있다.
이에 대해서는 후술하고, 지금은 BoW를 좀 더 자세히 살펴보자. 보통 BoW는 아래와 같은 Term-doucment count matrix를 통해 구현한다.
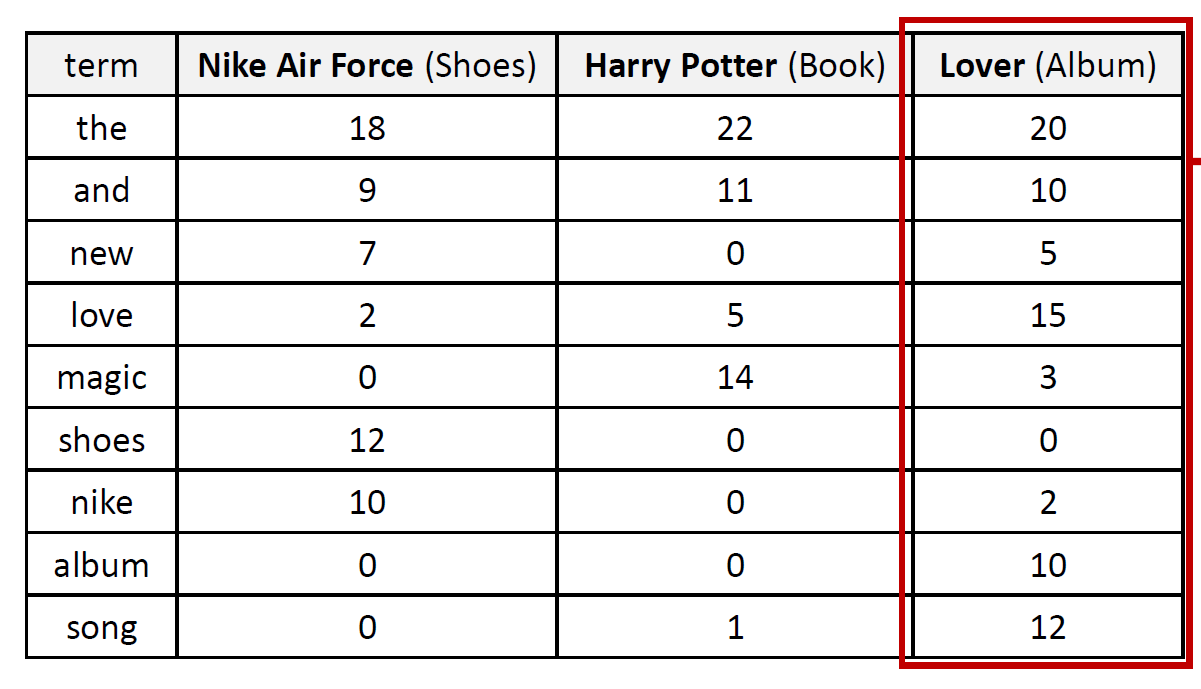
말 그대로 Row가 각 term을, Column이 각 document를 의미하며, 각 cell에 는 해당 term이 해당 document에 등장한 횟수를 기록하면 된다. 물론 실제로 존재하는 단어의 수는 상당히 많기 때문에 대부분의 cell의 값이 0이 될 것이다. 그렇기 때문에 이를 “Sparse vector”라고 한다.
그런데 재밌는 점은, column 위주가 아니라 row 위주로 생각해볼 수도 있다는 것이다. 이 경우 각 단어가 어떤 document에 얼마나 등장했는지를 파악할 수 있는 벡터가 된다. 이러한 관점에서 각 word의 vector를 구성해볼 수 있는데, 여기에는 Word-word co-occurrence matrix를 활용한다.
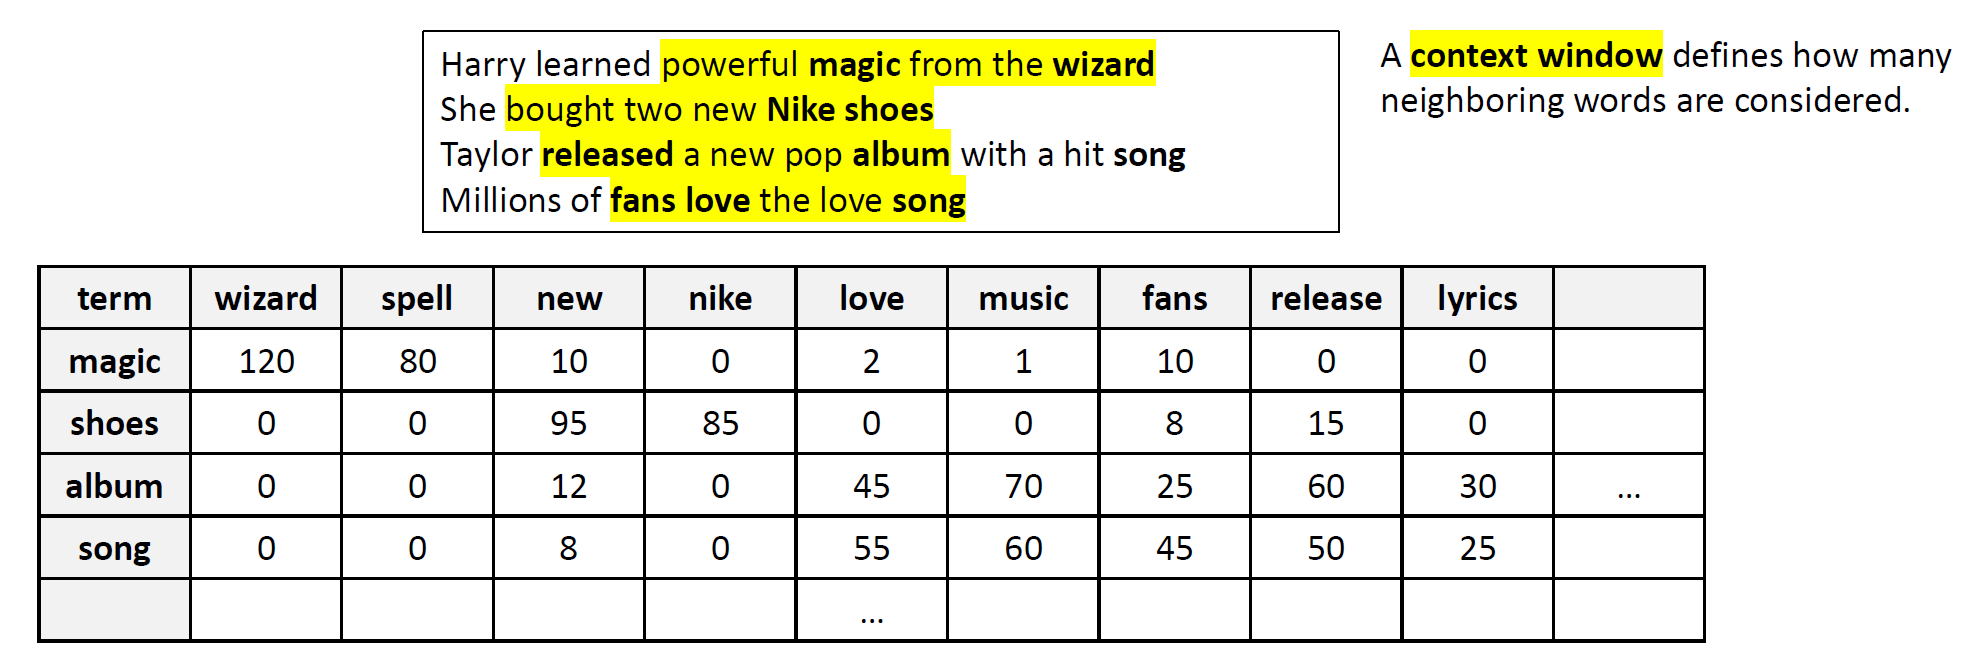
Word-word co-occurrence matrix는 “Term-context matrix”라고도 불리며, Vocabulary X Vocabulary의 크기를 가지는 Square matrix이다. 여기서 각 cell은 해당하는 두 단어가 얼마나 비슷한 맥락에 등장했는가를 카운트한 값인데, 이 “비슷한 맥락”을 정의하기 위해 Context window라는 개념을 사용한다. Context window는 간단히 얼마나 멀리까지 인접한 단어까지 카운트할 것인가를 결정하는 값으로, 위 사진에서는 그 크기가 5가 된다.
그러면 이 BoW의 한계점은 무엇일까? 앞에서도 잠깐 언급했지만 BoW에서 유지되는 유일한 정보는 각 단어의 frequency뿐이라는 것이다. 물론 frequency도 충분히 유용한 정보긴 하지만, freqeuency가 항상 좋은 지표는 아니라는 점이 문제다.
대표적으로 어떤 상황에서든 항상 등장하기 마련인 “the”, “it” 같은 단어를 생각해보자. 이러한 단어들은 빈도는 매우 높게 기록되겠지만 실질적으로 그 document에 대해 유의미한 정보를 제공해주진 않을 것이다. 여기서 더 나아가서, topic-specific한 단어도 생각해볼 수 있다. “song”, “singer” 같은 단어들은 당연히 운동화보단 앨범의 설명에 더 자주 등장할 것이고, 이는 매우 당연하다. 그런데 앨범에 설명에 이러한 단어들이 많이 등장한다고 해서 거기서 뭔가 유의미한 정보를 얻어내긴 힘들다.
즉, 단순히 frequency만으로는 어떤 단어가 해당 document에 대해 얼마나 중요한지를 판단하기 어렵다는 것이다.
TF-IDF weighting
BoW의 이러한 문제를 해결하기 위해 등장한 것이 바로 TF-IDF이다. TF-IDF는 TF와 IDF의 2가지 지표를 사용한다.
TF(Term Frequency)는 각 단어가 Document에 얼마나 자주 등장했는지를 나타내는 지표고, IDF(Inverse Document Frequency)는 반대로 각 단어가 다른 Document에 얼마나 희박하게 등장했는지를 나타내는 지표이다. 그리고 최종적으로 이들의 값을 곱해서 벡터를 구성하며, 자연히 특정 Document에 많이 등장하면서 다른 Document에는 잘 등장하지 않는 단어일수록 TF-IDF weight가 높아지게 된다.
이제 각각에 대해 조금 더 자세히 알아보자. Term Frequency $\text{tf}_{t,d}$는 term $t$가 document $d$에 등장한 횟수를 의미한다. 그런데 BoW의 한계점에서 알 수 있듯이, 이 카운트가 해당 단어의 중요도에 선형적으로 비례하는 것은 아니다. 그렇기 때문에 TF는 보통 아래와 같이 $\log$를 취해서 계산한다.
\[\text{tf}_{t,d}=\begin{cases}1+\log_{10}(\text{count}(t,d)),\quad &\text{if count}(t,d)\gt 0 \\ 0,&\text{otherwise}\end{cases}\]여기서 1을 더해주는 것은 0이 되는 것을 방지하기 위함이다.
Inverse Document Frequency $\text{idf}_t$는 term $t$가 전체 document에서 얼마나 희박하게 등장하는지를 판별하는 지표이다. 희박함을 따지는 이유는, 역시 다양한 document에 걸쳐서 공통적으로 자주 등장하는 단어들은 유의미한 정보를 제공하지 못하기 때문이다. IDF는 아래와 같이 계산한다.
\[\text{idf}_{t}=\log_{10}\left(\dfrac{N}{\text{df}_t}\right)\]여기서 $N$은 전체 document의 수, $\text{df}_t$는 term $t$가 등장한 document의 수를 의미한다.
이 둘의 값을 곱해서 최종적으로 TF-IDF weight를 계산한다. 주의할 점이 2가지가 있는데, 우선 TF는 term과 document에 영향을 받는 값이지만, IDF는 term에만 영향을 받는 값이라는 점과 TF-IDF weight를 계산해보면 BoW보다도 더 Sparse한 vector가 만들어진다는 점이다.
이는 곱셈의 특성상 둘 중 하나가 0이면 최종적으로 0이 되기 때문인데, 특히 IDF의 경우에는 모든 document에 등장한 단어는 0이 되므로 이러한 단어는 TF-IDF weight 역시 0이 되게 된다. 사실 이는 의도된 것인데, 여기서도 0이 되는 값은 의미가 없는 정보라는 뜻이기 때문이다. 즉 중요한 정보를 더 드러내고자 하는 목적에 충실하다고 할 수 있다.
Similarity
그러면 이렇게 변환된 두 벡터가 얼마나 유사한지는 어떻게 알 수 있을까?
우선 document $d$와 query $q$가 주어졌다고 생각해보자. 이들의 유사도를 계산하기 위해서 우선 document $d$에 대해서 TF-IDF weight, 즉 \(\text{tf}_{t,d}\times\text{idf}_t\)를 계산한다. 그리고 query $q$에 대해서는 TF \(\text{tf}_{t,q}\)만 계산한다.
즉, query에 대해서 IDF는 계산하지 않는 셈인데, 이는 query는 보통 document보다 훨씬 짧기 때문에 IDF를 계산하게 되면 대부분이 0으로 가기 때문이다.
이렇게 두개의 벡터를 구했는데, 이들의 유사도를 계산할 때 가장 먼저 생각할 수 있는 방법은 Inner product일 것이다. 그러나 이 경우엔 Inner product가 그리 좋은 방법은 아닌데, 이는 결국 각 단어의 frequency가 반영되기 때문이다.
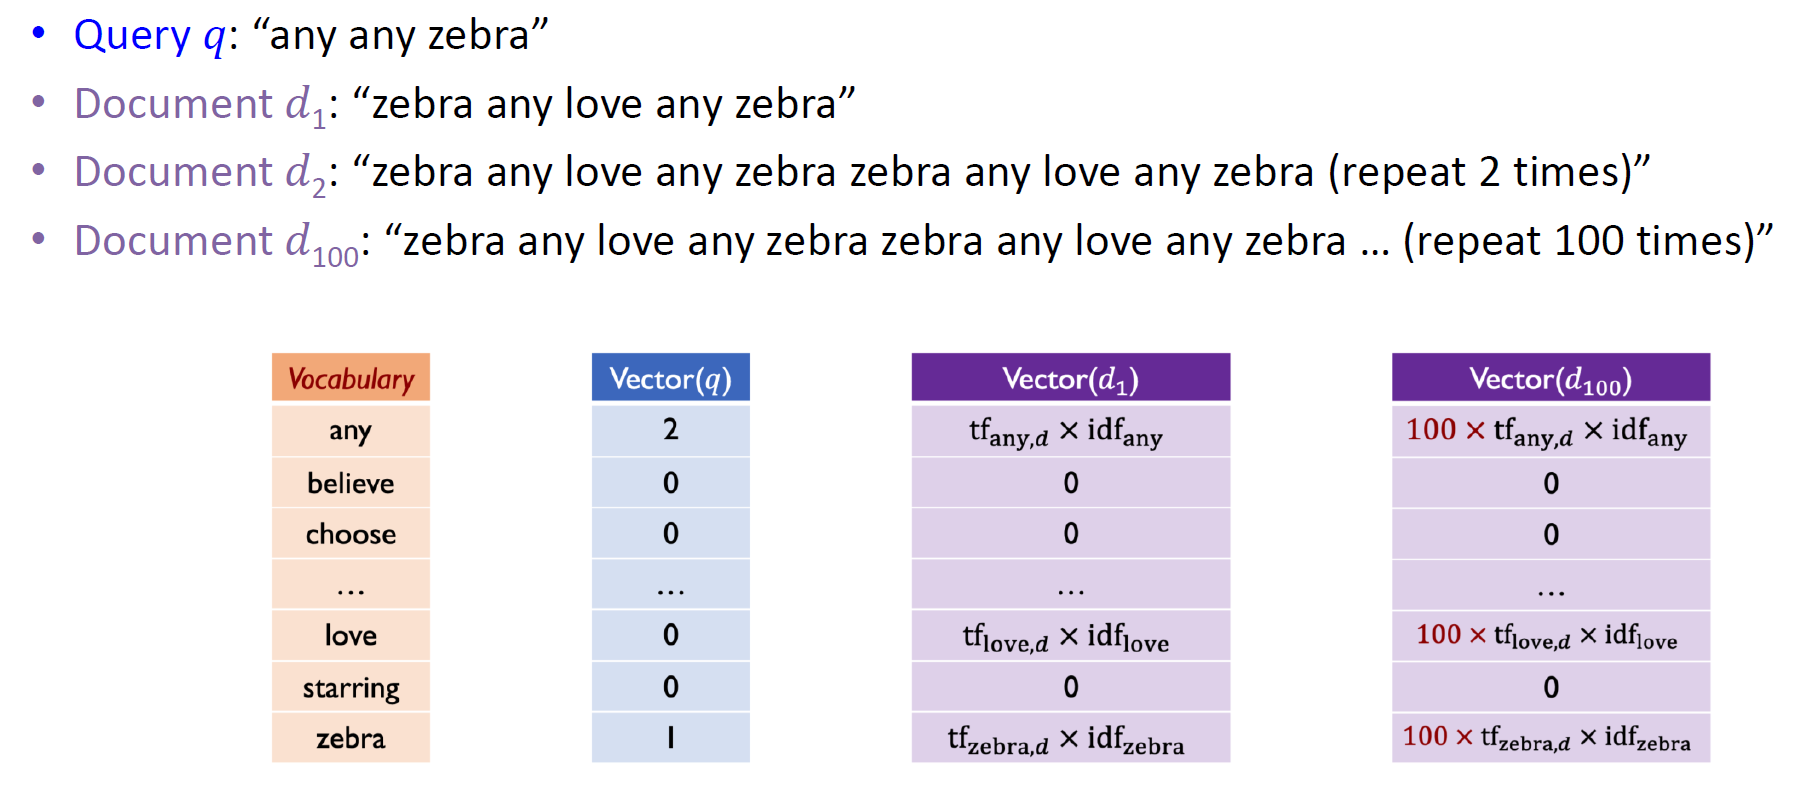
위 사진과 같이, 결과적으로 일치하는가만 따지면 되는 상황에서 한 번 더 반복되었다는 이유로 Inner product가 더 커지게 되는 현상이 발생하게 된다.
그렇기 때문에 Sparse representation에서는 Inner product 대신 Cosine similarity를 사용한다. Cosine similarity는 다음과 같이 계산된다.
\[x=[x_1,x_2,\cdots,x_N],\quad y=[y_1,y_2,\cdots,y_N]\] \[\text{cos}(x,y)=\dfrac{x_1y_1+x_2y_2+\cdots+x_Ny_N}{\sqrt{x_1^2+x_2^2+\cdots+x_N^2}\times\sqrt{y_1^2+y_2^2+\cdots+y_N^2}}=\dfrac{x\cdot y}{\lVert x\rVert\lVert y\rVert}=\left(\dfrac{x}{\lVert x\rVert}\right)\cdot\left(\dfrac{y}{\lVert y\rVert}\right)\]즉, 각 벡터의 크기를 1로 정규화한 후의 내적을 구하는 것과 같다. 이렇게 되면 이 두 벡터의 크기에 영향받지 않고, 오로지 각도에만 영향을 받게 된다.
Summary
Sparse representation은 빠르고 간편하게 구할 수 있는 방법이라 소규모의 vocabulary에서는 충분히 유용하게 사용할 수 있다. 그러나 치명적인 단점 3가지가 있어 요즘은 직접적으로 사용하진 않는 편이다.
우선 각 단어가 하나의 축을 담당하게 되므로 차원의 수가 굉장히 커지게 된다. 이는 곧 소위 말하는 차원의 저주에 시달리기 쉽다는 뜻이며, 그렇지 않더라도 불필요하게 비효율적인 연산을 야기하게 된다.
또한 단어의 빈도만 계산하고 순서를 보존하지 못하기 때문에 순서에 영향받는 문장의 의미를 제대로 살리기 어렵다. “the horse ate”와 “ate the horse”는 같은 단어로 이루어진 문장이지만 순서때문에 의미가 정 반대가 되는데, Sparse representation에서는 이를 동일한 의미로 보게 된다.
마지막으로 문맥도 보존하지 못하기 때문에 문맥에 영향을 크게 받는 단어들, 특히 동의어의 의미를 제대로 해석하기 어렵다. “bank”란 단어는 둑이 될수도 은행이 될수도 있으며 문장 속에서 어떻게 사용되었는지는 문맥을 통해서만 알 수 있다. 그러나 Sparse representation에서는 이러한 문맥을 전혀 고려하지 못하기 때문에 어떠한 의미로 “bank”를 사용했는지 파악할 수 없게 된다.