Deep Reinforcement Learning 5 - Model-free Control (1)
Before starting
“Class” 카테고리에 있는 포스팅들은 실제로 수업에서 배운 내용을 정리하려는 목적으로 작성되었다. 이 글은 그 중 Deep Reinforcement Learning 과목의 수업을 다룬다.
Model-free Control
Dynamic Programming으로 Control 문제를 해결하는 과정을 다시 떠올려보자. Prediction 문제를 풀어 Policy Evaluation을 수행한 후, 이를 기반으로 Policy Improvement를 수행하고 이를 반복하는 Policy Iteration을 통해 Control 문제를 해결했었다.
Model-free 상황에서도 이 기본 골자는 달라지지 않는다. 즉, Policy Evaluation과 Policy Improvement를 반복 적용하면 된다. 여기서 사용할 Policy Evaluation이 바로 저번 글에서 다루었던 Monte-Carlo Learning과 Temporal-Difference Learning이다.
Monte-Carlo Policy Iteration
먼저 Monte-Carlo Policy Evaluation을 통해 Control 문제를 풀어보자.
Dynamic Programming에서 사용했던 방법을 되짚어보면, Greedy하게 Policy Improvement를 수행했었다. 그러나 이 방법은 MDP를 전부 아는 Model-based 상황에서만 가능한 방법이다.
\[\pi^{\ast}(s)=\arg\max_a R_s^a+\gamma\sum_{s^{\prime}\in S}\left(P_{ss^{\prime}}^aV(s^{\prime})\right)\]즉, State Transition Probability Matrix를 알아야 $P_{ss^{\prime}}^a$를 알 수 있고, 그래야 위 수식대로의 Greedy한 선택이 가능하다. 지금 다루고자 하는 Model-free 상황에서는 이 값을 모르기 때문에, 어떤 식으로 Action을 선택해야 우리가 원하는 State로 이동할 수 있는지 모른다.
\[\pi^{\ast}(s)=\arg\max_a Q(s,a)\]따라서 DP에서 사용했던 Greedy Policy Improvement 대신, Action Value Function $Q$를 기반으로 Policy Improvement를 수행해야 한다. 이 $Q$는 MC Learning을 통해 충분히 구할 수 있는 값인데, MC Learning에서 $V(S)$ 대신 $Q(S,A)$를 넣으면 동일하게 계산이 된다.
$\epsilon$-Greedy Exploration
그런데 State Value Function 대신 Action Value Function을 사용하면 한 가지 문제가 생긴다. Action Value Function은 Action까지 고정된 형태이기 때문에 우리가 가장 큰 $Q$값을 골랐다면 거기서 정해진 Action만을 선택하게 된다. 즉, 나머지 Action들은 제대로 확인하지 못하게 된다.
이러한 문제를 해결하기 위해선 Exploration이 필요하다. $\epsilon$-Greedy Exploration은 이러한 Exploration 중 하나인데, 간단하게 작은 값 $\epsilon$을 설정해서, 이 $\epsilon$의 확률로는 랜덤한 Action을 수행하도록 만드는 방법이다.
\[\pi^{\ast}(a\vert s)=\begin{cases}\arg\max_{a} Q(s,a) & \text{with}\,1-\epsilon\,\text{probability} \\ \text{any}\,\text{action}\,a & \text{with}\,\epsilon\,\text{probability} \end{cases}\]Greedy in the Limit with Infinite Exploration
이 Monte-Carlo Control이 잘 수렴하기 위해서는 Greedy in the Limit with Infinite Exploration(GLIE) 조건을 만족해야 한다. GLIE는 다음의 2개 조건을 의미하며, 이들을 모두 만족해야 한다.
$n\rightarrow\infty$일 때,
- 모든 State-Action Pair는 각각 무한히 많이 방문되어야 한다.
- Policy는 Greedy Policy에 수렴해야 한다. (Exploration이 포함되어도 최종적으론 Greedy Policy가 되어야 한다.)
이들을 모두 만족하는 GLIE MC Control은 2번째 조건을 만족하기 위해 학습이 진행됨에 따라 $\epsilon$ 값을 점점 줄여 0에 수렴되게 한다.
Monte-Carlo Control
이상의 내용을 종합하면 아래 사진과 같다.
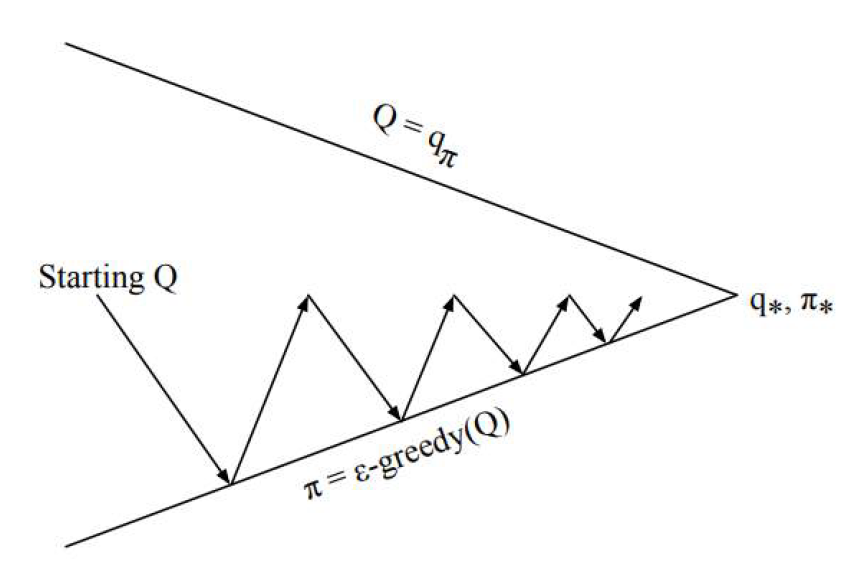
Policy Evaluation에는 Monte-Carlo Policy Evaluation을, Policy Improvement에는 $\epsilon$-Greedy Exploration을 사용한다. 그런데 Monte-Carlo Learning은 Episode를 여러 번 수행하고 한번에 업데이트하는 방식이 아니라 매 Episode마다 업데이트를 수행한다.
따라서 그러한 Incremental Policy Evaluation을 그대로 사용해서, 매 Episode마다 Policy를 Evaluation하고 그걸 바탕으로 $\epsilon$-Greedy Exploration을 수행하는 식으로 최적화를 할 수도 있다.
전체 알고리즘을 정리하면 다음과 같다.
Policy $\pi$를 사용해 Episode $\lbrace S_1A_1R_2\ldots S_T\rbrace\sim\pi$를 Sampling한다.
각각의 State $S_t$와 Action $A_t$에 대해, 다음과 같이 업데이트한다.
\[N(S_t,A_t)\leftarrow N(S_t,A_t)+1\] \[Q(S_t,A_t)\leftarrow Q(S_t,A_t)+\dfrac{1}{N(S_t,A_t)}(G_t-Q(S_t,A_t))\]업데이트된 Action Value Function을 기반으로 Policy를 개선한다.
\[\epsilon\leftarrow\dfrac{1}{k}\] \[\pi\leftarrow\epsilon\text{-greedy}(Q)\]
SARSA
그러면 Temporal-Difference Learning을 사용해서는 Control 문제를 어떻게 풀 수 있을까? 우선 TD Learning은 MC Learning에 비해 Variance가 낮고 Episode가 끝나지 않아도 업데이트가 가능하다는 장점이 있다. 이 Online이 가능하다는 점으로 인해 TD Learning을 사용하면 Episode가 끝날때가 아니라 매 Time-step이 끝날 때마다 업데이트가 가능하다.
이 Policy Evaluation 방법을 State-Action-Reward-State-Action(SARSA)라고 부른다.
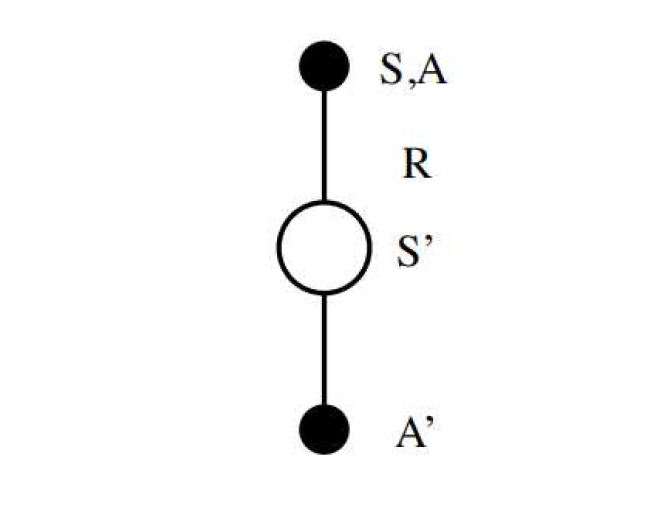
위 그림에서도 보이듯이, 현재 State 및 Action, 그리고 여기에서 얻어지는 Reward와 다음 State 및 Action을 순서대로 요약한 것이다. 수식으로 표현하면 SARSA는 다음과 같이 업데이트된다.
\[Q(S,A)\leftarrow Q(S,A)+\alpha(R+\gamma Q(S^{\prime},A^{\prime})-Q(S,A))\]Policy Improvement는 동일하게 $\epsilon$-Greedy Exploration을 사용한다. Monte-Carlo Control과 다른 점은 Policy Evaluation이 SARSA로 바뀌었다는 점, 그리고 업데이트의 주기가 Episode 단위가 아니라 Time-step 단위라는 점 정도이다.