Text Mining 5 - Learning with Limited Labels (1)
Before starting
“Class” 카테고리에 있는 포스팅들은 실제로 수업에서 배운 내용을 정리하려는 목적으로 작성되었다. 이 글은 그 중 Text Mining 과목의 수업을 다룬다.
Limited Labels
저번 글에서 다뤘던 Classification Task는 결국 모든 데이터에 대해 Label이 존재한다는 가정 하에 진행된 것이었다. 하지만 실제로는 Labeled data가 존재하지 않는 경우가 훨씬 많다. 그래서 이러한 Unlabeled data를 어떻게 학습에 사용할 수 있을지를 생각해야 한다.
이러한 Limited label 문제를 해결하기 위해선 크게 다음의 3가지 방법을 사용하며, 각각 서로 다른 문제를 제시하기 때문에 이들 세 방법은 모두 상호 보완적이다.
- Semi-supervised Learning: Labeled data가 굉장히 적고 대부분의 데이터가 Unlabeled data일 때 이를 어떻게 다룰 수 있을까?
- Multi-task Learning: 한 Classifier Task가 충분한 Label을 갖지 못하고 있다면, 관련 있는 다른 Task에서 유용한 학습 정보를 가져올 방법은 없을까?
- Adversarial Learning: Labeled Data와 Unlabeled Data의 분포가 다르다면, 이를 어떻게 다뤄야 효과적일까?
Semi-supervised Learning
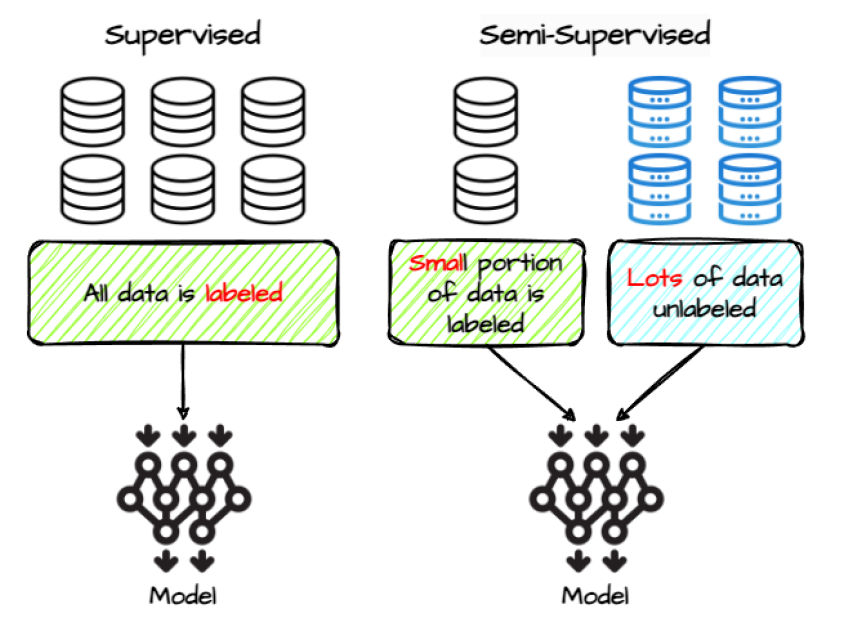
위 그림은 Supervised Learning과 Semi-supervised Learning의 차이를 보여준다. 모든 데이터가 예쁘게 Labeling된 Supervised Learning과는 달리, 상당수의 데이터가 Unlabeled data이다. 이들을 무시하고 그냥 Labeled data만 사용해 학습하는 방법도 있지만, 이 버려지는 데이터까지도 활용해서 모델의 성능을 끌어올리고 싶으며, 사실 Unlabeled data는 구하는 것이 훨씬 쉬워서 이를 잘 활용할 수만 있다면 데이터의 양 자체는 압도적으로 많이 확보할 수 있다. 이것이 바로 Semi-supervised Learning(SSL)의 목적이다.
이 “활용”에 대해 좀 더 구체적으로 알아보자.
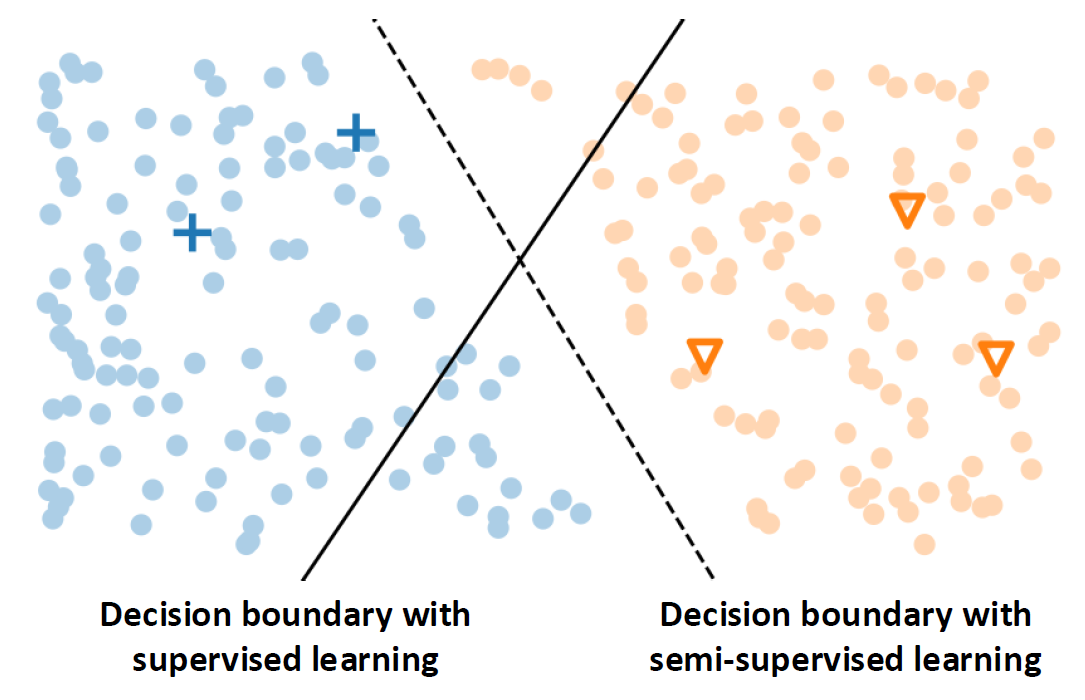
위 사진에서 십자가 및 역삼각형으로 표기된 것이 Labeled data이고, 그 외의 다른 점들은 전부 Unlabeled data이다. 이 상황에서 Supervised Learning만으로 이들을 잘 분류하는 Classifier를 fine-tuning하게 되면 위 사진의 실선과 같은 Decision boundary를 형성할 것이다.
그러나 이 Decision boundary는 Labeled data는 잘 분류해주지만, Unlabeled data의 분포는 반영하지 못하는 것을 볼 수 있다. 그래서 이 Decision boundary를 점선과 같이 바꿔, 좀 더 잘 generalize하게 하는 것이 Semi-supervised Learning의 목표라고 할 수 있다.
Semi-supervised Learning은 Dataset을 다음과 같이 정의한다.
\[D_l=\{(x_1,y_1),(x_2,y_2),\ldots,(x_n,y_n)\},\quad D_u=\{x_{n+1},x_{n+2},\ldots,x_{n+m}\},\quad m\gg n\]즉, 데이터의 상당수는 Label이 없어 $D_u$와 같이 단일 원소로만 존재하며, 소수의 데이터만 Labeling이 되어 일반적인 Supervised Learning에서 정의하는 Dataset과 같은 $D_l$의 형태로 존재한다.
또한 Semi-supervised Learning은 다음의 2가지 가정에 기반하고 있다.
- Smoothness assumption: Input space에서 가까운 데이터들은 유사한 Label을 갖는다.
- Low-density assumption: 좋은 decision boundary는 데이터가 많이 밀집된 지역을 피해야 한다.
두 assumption 모두 직관적이다. 이들 assumption을 바탕으로, Semi-supervised Learning은 크게 Pseudo Labeling과 Consistency Regularization의 2가지 방법으로 나눌 수 있다. 이 글에서는 이 중 Pseudo Labeling에 대해 다룬다.
Pseudo Labeling
처음에 Labeled data만 가지고 학습을 진행하다 보면, 몇몇 Unlabeled sample에 대해서도 높은 confidence를 가질 수 있다. 이들은 Smoothness assumption에 기반하여, 운 좋게 Labeled data 근처에 위치한 데이터들이다. 이러한 데이터들에 대해 모델이 높은 confidence로 예측한 그 결과를 그냥 label로써 간주하고 학습을 이어나가자는 것이 Pseudo Labeling의 핵심 아이디어이다.
전체적인 Process는 다음과 같다.
- Labeled dataset을 가지고 Supervised Learning을 진행한다.
- 학습된 모델로 Unlabeled data에 대해 예측을 수행해본다.
- 이 중 confidence가 높은 샘플들을 찾아 그 예측값을 Pseudo Label로 간주하여, Pseudo-Labeled dataset을 구성한다.
- 기존의 dataset에 새롭게 얻은 dataset을 합쳐 모델을 다시 학습시킨다.
이 과정을 몇 번 반복하다보면, 점점 더 많은 Unlabeled data에 Pseudo Label이 생기게 되어, 궁극적으론 대부분의 데이터를 다 커버할 수 있을 것이다라는 발상이다.
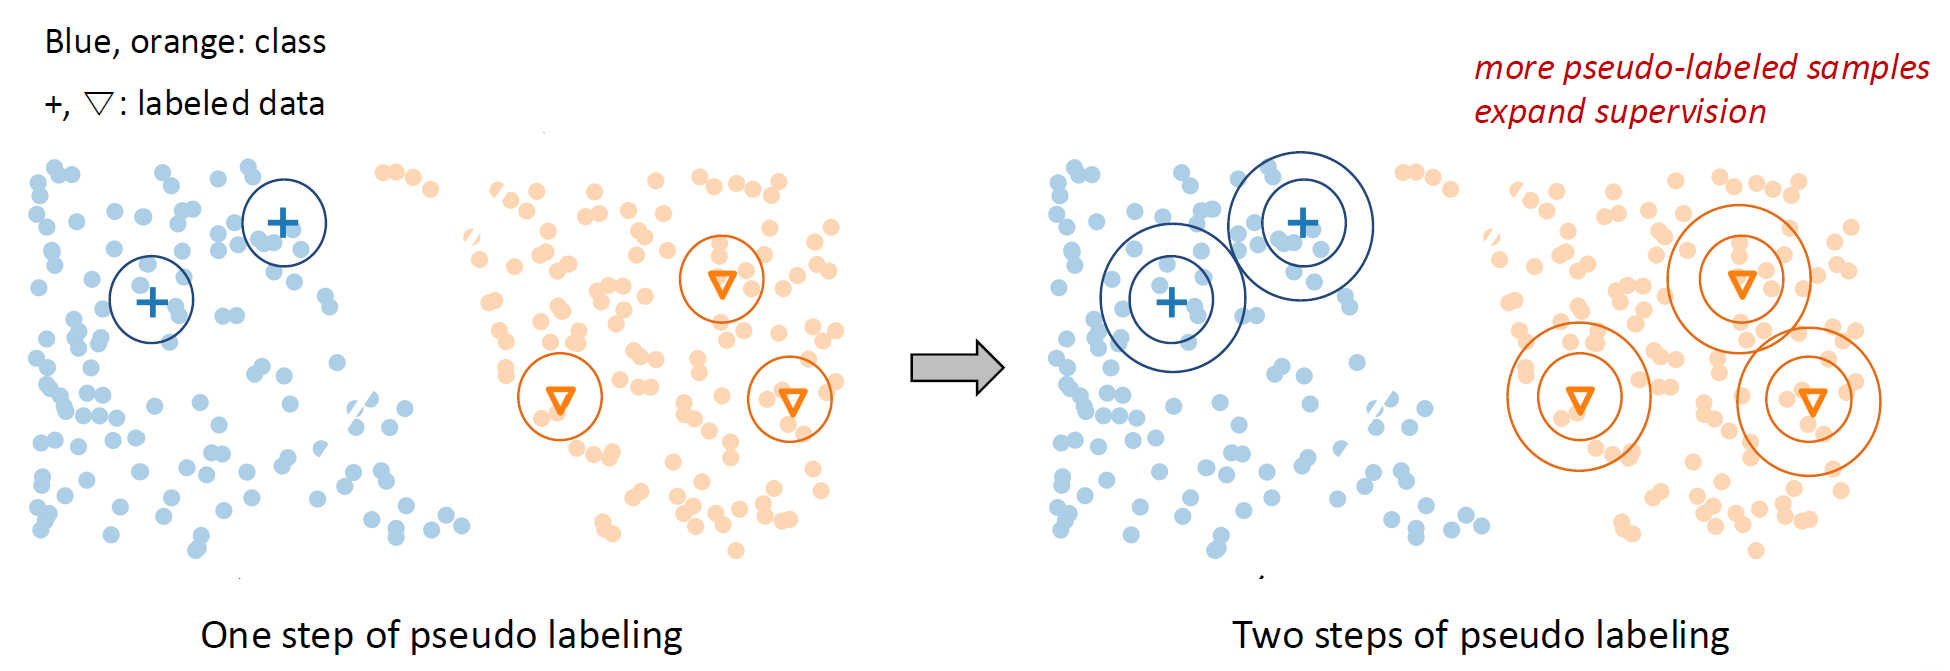
즉, 한번만 수행하는 작업이 아니라 이 과정을 여러 번 반복하는 것이다. 그리고 이 과정은 마치 “스스로 정답을 찾아 학습”하는 것처럼 보이기 때문에 이러한 Iterative pseudo-labeling을 Self-training이라고 부른다.
이를 실제로 구현한다면 “높은 Confidence”의 기준점이 될 Confidence threshold $\tau$를 정해야 하고, 이 값은 학습을 통해 얻어지는 값이 아니라 Hyperparameter가 된다.
Pseudo Labeling은 간단하면서도 효과적인 방법이지만 만능의 방법은 아니다. 가장 큰 문제로 모델이 자동으로 붙여주는 Pseudo Label 자체가 Human Labeling만큼 정확할 수가 없다는 것이다. 그래서 worst case에서는 오히려 Supervised Learning만으로 학습한 것과 비슷하거나 혹은 성능이 오히려 떨어질 수도 있다.
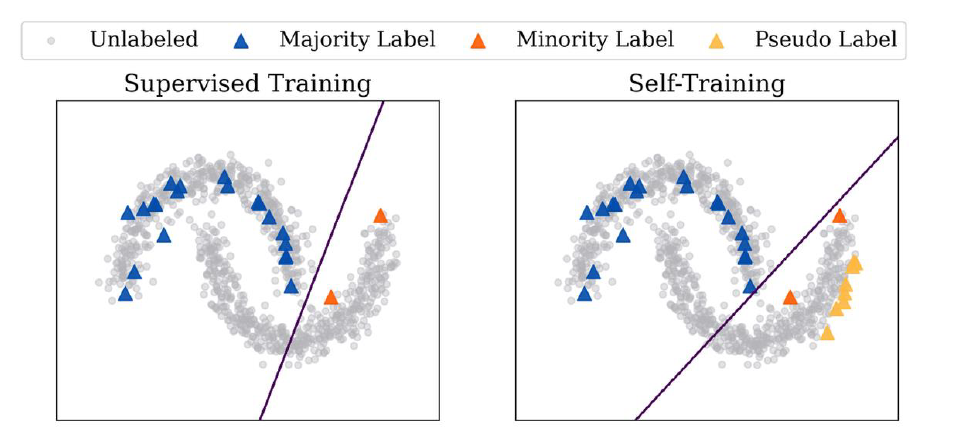
위 사진이 바로 그 worst case scenario를 보여준다. 위 케이스에서 Minority Label이 애초에 오른쪽에만 딱 2개가 있기 때문에, Pseudo Labeling을 통해 학습 범위를 넓혀도 이 영역에서 벗어나지 못하는 문제가 발생한다. 그래서 Labeled data만 가지고 학습했을 때와 크게 다르지 않은 결과가 나오게 된다.
요약하자면 Pseudo Labeling은 데이터의 분포를 전파할 수 있는 방법이지만, 그와 동시에 Error도 같이 전파된다. 한번 잘못된 Pseudo Label이 붙어버리면 모델 자체적으로는 이를 교정할 수 없고 오히려 확산되게 된다.
또한 모델이 전반적으로 overconfident하다는 문제도 존재한다. 이는 애초부터 Pseudo Labeling의 대상이 되는 Unlabeled data는 $\tau$를 넘은 confidence가 나오는 데이터이기 때문이다. 즉, 애초부터 어느 정도 확신이 있는 데이터를 여러 번 반복해서 학습시키는 것이므로, 이러한 데이터들에 대해서 모델이 점점 더 확신을 갖게 된다.
이 현상은 사실 모델이 정답을 예측할 때는 큰 문제가 되진 않지만, 위의 Error propagation 문제와 맞물리면 결국 모델이 갖고 있는 지식까지 망가지는 결과가 발생하게 된다.