Text Mining 6 - Learning with Limited Labels (2)
Before starting
“Class” 카테고리에 있는 포스팅들은 실제로 수업에서 배운 내용을 정리하려는 목적으로 작성되었다. 이 글은 그 중 Text Mining 과목의 수업을 다룬다.
Consistency Regularization
Consistency Regularization은 저번 글에서 다뤘던 Semi-supervised Learning의 방법 중 하나다. Input에 작은 변화를 가해도 동일한 예측을 해야한다는 점이 Consistency Regularization의 핵심 아이디어이다.
사실 이 전제는 Semi-supervised Learning 뿐만이 아니라 일반적인 Supervised Learning에서도 적용된다. 모델의 예측을 좀 더 안정화시키기 위해 Noise나 Augmentation 등의 작은 Perturbation을 추가하는 것이 바로 이 전제를 기반으로 한 것이다.
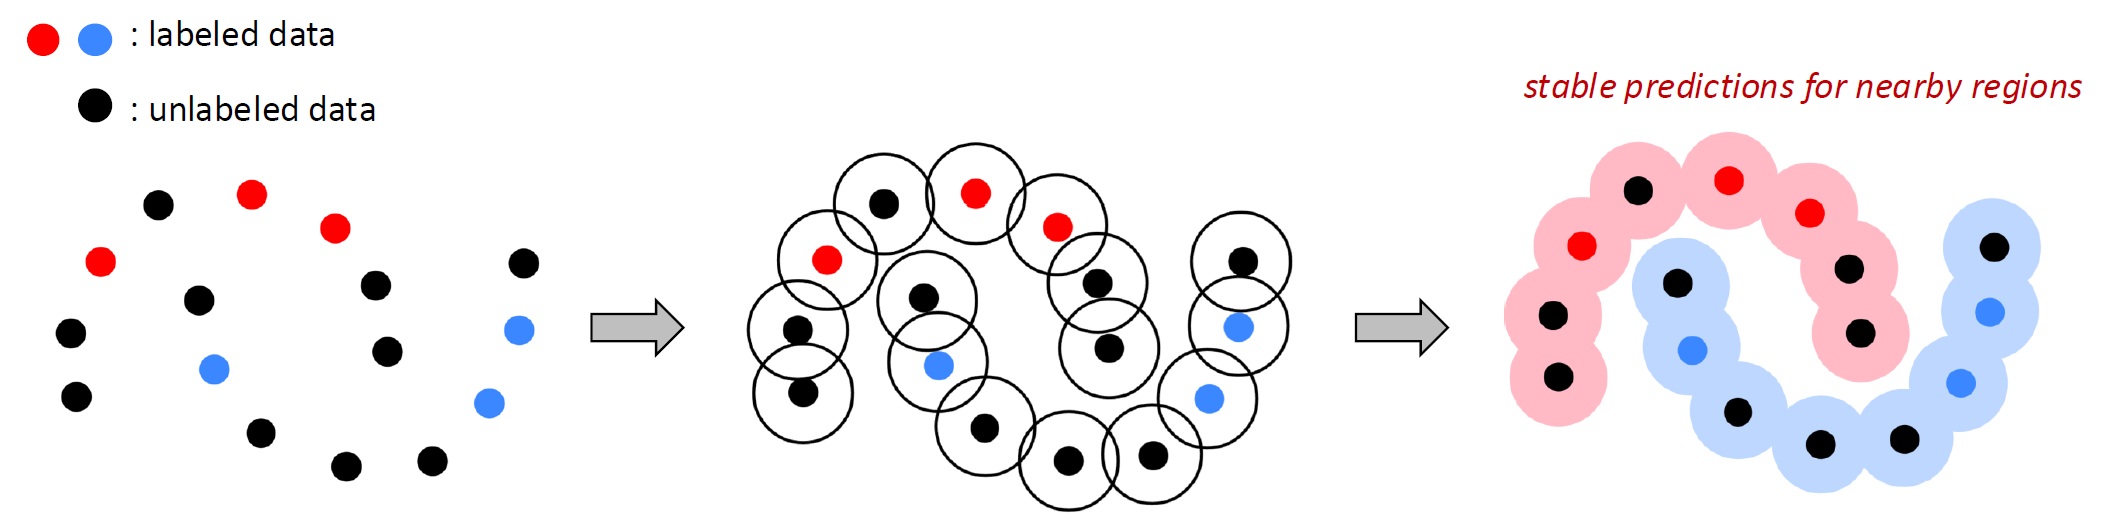
실제로 동작하는 원리도 동일하다. 즉, 위 사진과 같이 각 Data 주변의 좁은 영역에도 전부 같은 예측을 내놓을 것이라는 전제 하에서, 이 좁은 영역이 겹치는 Unlabeled Data에 대해서도 같은 예측이 나와야 하니 이런 식으로 Decision Boundary를 형성할 수 있게 된다. 이를 통해 자연스럽게 Low Density Assumption도 성립하게 된다.
Consistency Regularization을 실제로 적용하기 위해서는 다음과 같이 Loss term $\mathcal{L}_{\text{cons}}$를 추가해야 한다.
\[\mathcal{L}=\mathcal{L}_{\text{sup}}(D_l)+\lambda\mathcal{L}_{\text{cons}}(D_l\cup D_u)\] \[\mathcal{L}_{\text{cons}}=\mathbb{E}_{x\in D_l\cup D_u}\left[\lVert f(x;\theta)-f(\tilde{x};\theta)\rVert^2\right]\]여기서 $x$는 Original Input, $\tilde{x}$는 Perturbed Input이다. 이 새로 추가된 Loss term이 Original Input과 Perturbed Input의 예측값이 크게 다르지 않아야 할 것을 요구하며, 이를 통해 Consistency를 강제할 수 있다.
이러한 Perturbation은 다양한 방법으로 추가할 수 있다. 작은 Random Gaussian Noise를 추가하거나, 일부 단어에 대한 Dropout 혹은 Masking, 혹은 Vision 등에서와 같이 Data Augmentation을 그대로 적용할 수도 있다.
그런데 이 방법의 이름은 Consistency “Regularization”이다. 이는 즉 Overfitting을 막기 위한 Regularization에 해당한다는 의미이다.
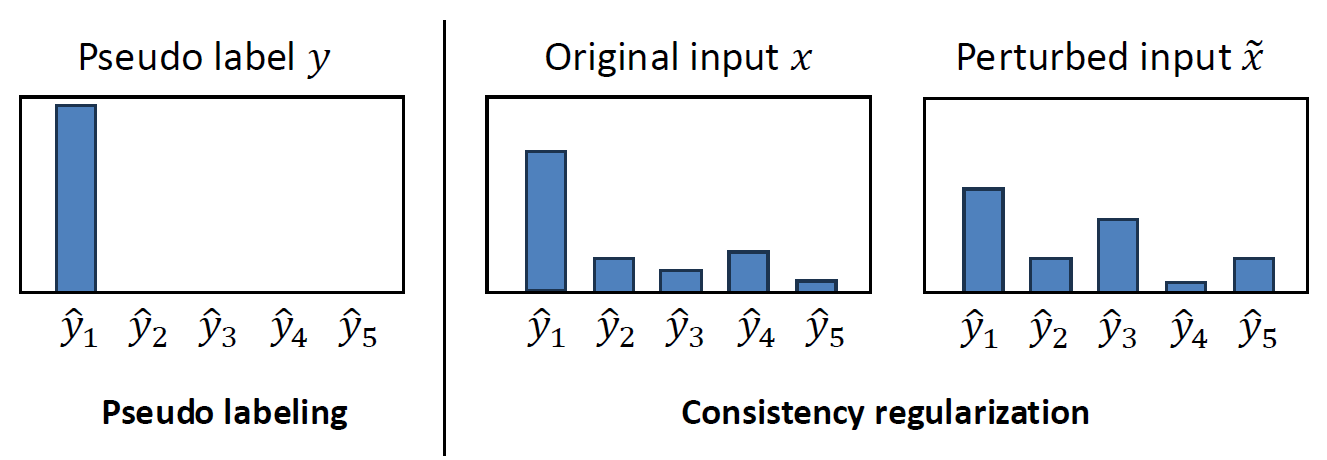
실제로 위 사진과 같이, Consistency Regularization을 적용하면 모델의 Confidence를 낮춰주는 효과가 있다. 이는 Perturbed input $\tilde{x}$에는 Noise가 있기 때문에 모델이 이 Input을 직접적으로 보지 못하기 때문이다. 이는 Confidence를 높이는 Pseudo Labeling과 정 반대의 효과를 낸다.
또한 Consistency Regularization은 모든 Unlabeled Data를 사용한다. 이는 Unlabeled Data를 학습 신호의 확장으로 사용하는 것이 아니기 때문이다. 이 점에 있어서도 Labeled Data 근처의 Unlabeled Data를 활용하는 Pseudo Labeling과 다르다는 것을 알 수 있다.
Temporal Ensemble
이렇듯 Consistency Regularization은 간단하면서도 유용한 기법이라 널리 쓰이지만, 실제로 적용할 경우 문제가 하나 생긴다. Target 자체가 Noisy하기 때문에 모델의 예측이 너무 불안정해진다는 점이다. 이 점이 직접적으로 정답이 존재하지 않는 Unlabeled Data를 사용하는 상황과 맞물려 모델의 예측이 학습 중에서도 수시로 계속 변하게 된다. 그래서 학습 자체가 굉장히 불안정해지는 문제가 생긴다.
보통 이러한 경우 사용하는 기법 중 하나가 Ensemble, 그 중에서도 특히 Bagging이다.
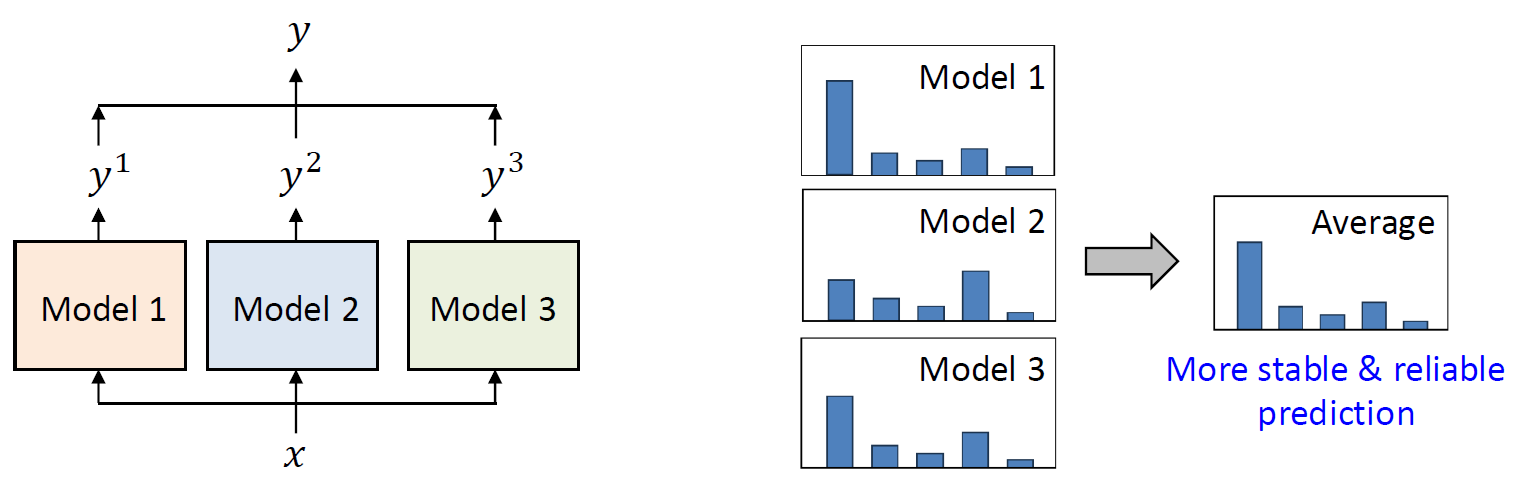
Bagging은 모델 하나의 입력이 불안정할 때, 즉 Variance가 높을 때 여러 모델을 병렬적으로 사용하여 그 평균을 취함으로써 Variance를 줄여주는 기법이므로 이 상황에 정말 적합한 방법이긴 하다.
그런데 여기서도 문제가 있다. 우리가 지금 다루고 있는 모델은 일반적으로 Bagging을 적용할만한 크기의 가벼운 모델이 아니라는 점이다. 그래서 여러 모델을 학습시키고 그들의 평균을 취하는 것은 너무 비싼 방법이다. 이로 인해 Bagging과 같은 효과를 단 하나의 모델만으로 낼 수 있는 방법에 대한 연구가 이루어졌고, 그 중 하나가 Temporal Ensemble이다.
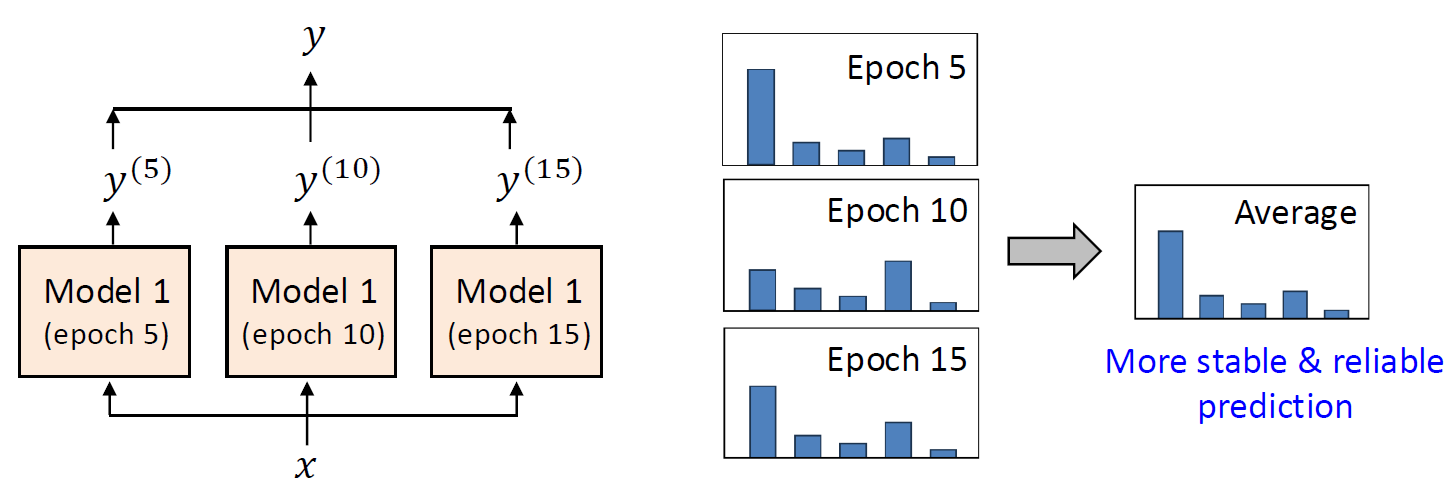
Temporal Ensemble은 이름 그대로 시간에 대한 Ensemble이다. 즉, 학습이 진행되는 동안 다양한 Epoch에서 얻어진 결과들을 취합하여 마치 여러 모델로부터 얻은 결과를 Bagging하는 듯한 효과를 주자는 것이다.
다만 이대로 수행하기 위해서는 모든 Data에 대한 예측을 모든 Epoch마다 다 저장해야 하는데, 이것도 사실 너무 비효율적인 일이다. 그래서 일반적으론 파라미터에 대한 Exponential Moving Average(EMA)를 사용해 구현한다. 이 방법을 특히 Mean Teacher라고 부르는데, 여러 시점의 예측값 대신 모델 파라미터 자체를 업데이트해서 여러 시점의 결과를 전부 저장할 필요를 없앨 수 있다.
\[\theta_{te}^{(t)}\leftarrow\alpha\theta_{te}^{(t-1)}+(1-\alpha)\theta^{(t)}\]금융권에서는 가중치 $\alpha$를 Smoothing Factor라고 부르며 별도로 계산하지만, 여기서는 그냥 Hyperparameter로 두고 사용한다. 여기서 $\theta^{(t)}$는 Epoch $t$에서의 Parameter, $\theta_{te}^{(t)}$는 Epoch $t$에서의 Temporal Ensemble Parameter를 의미한다. 즉, EMA를 통해 이전 Epoch에서의 Parameter를 따라가며 업데이트를 한다.
Summary
Consistency Regularization은 Pseudo Labeling과 달리 모든 Unlabeled Data를 사용할 수 있으며, Temporal Ensemble까지 추가해도 컨셉 및 구현이 간단한 편이라 널리 사용된다. 그러나 Confidence를 낮춰 학습이 불안정하다는 점 외에도 두 가지 단점이 더 알려져있다.
첫째로 Perturbation $\tilde{x}$를 어떻게 만드는지에도 영향을 받는다. 이를 Perturbation Sensitivity 문제라고 하며, 일반적인 방법 대신 도메인별로 특화시켜서 연구를 진행하고 있다고 한다.
둘째로 Weak Direct Guidance 문제가 있다. 다양한 Unlabeled Data를 사용하지만, 이들로부터 직접적인 Signal을 얻는 것이 아니기 때문에 Boundary는 여전히 불확실하게 된다.
그런데 재밌는 점은, 이들 장단점이 Pseudo Labeling과 정반대라는 것이다. 그래서 일반적으로 Semi-supervised Learning에서는 이 두 방법을 동시에 사용하며, 이는 현재까지도 크게 다르지 않다.
Multi-task Learning
Multi-task Learning은 Limited Label 문제를 Semi-supervised Learning과는 다른 관점에서 해결하려는 방법 중 하나이다.
아래와 같은 추천 시스템을 생각해보자.
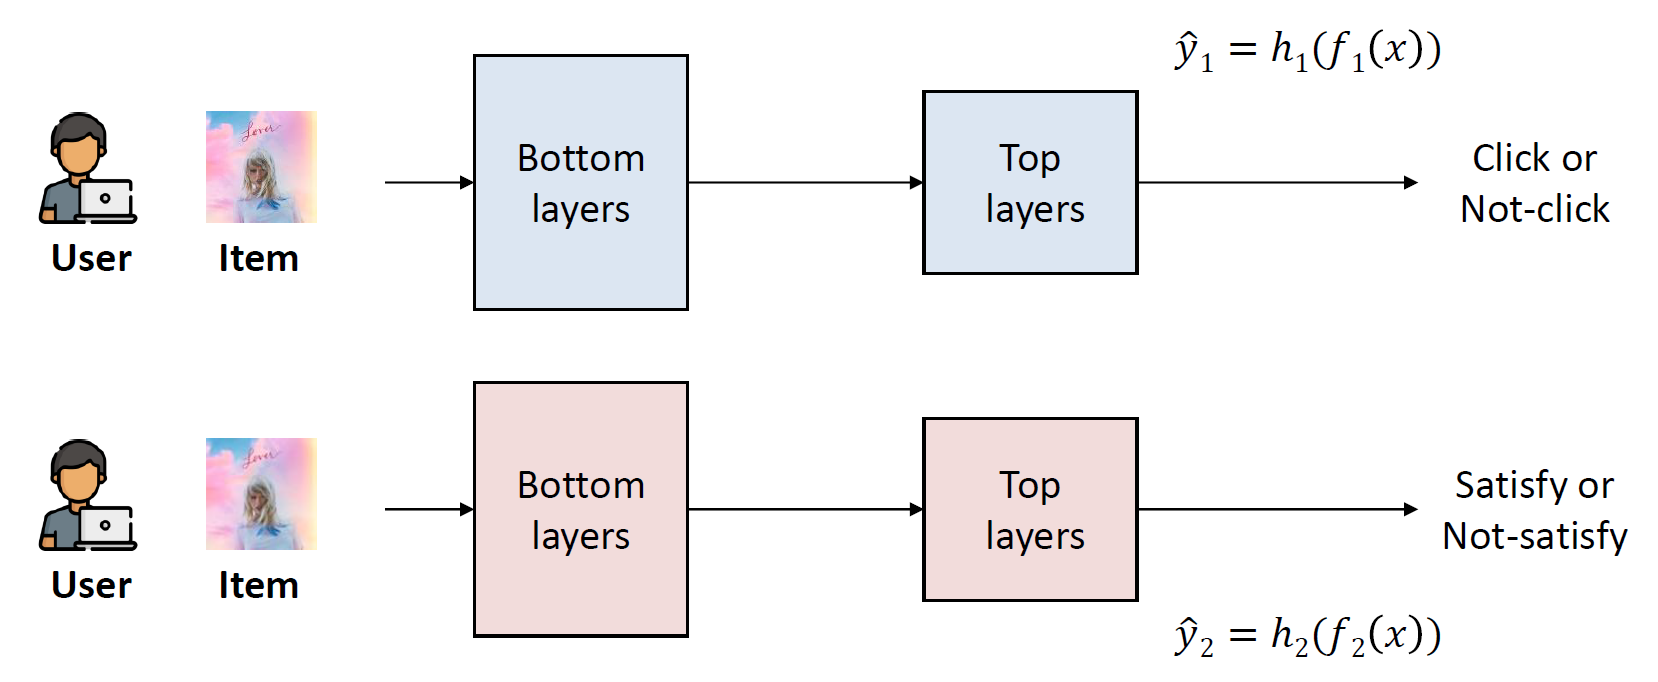
위 사진과 같이 2가지의 Task가 필요하다고 하자. 이는 각각 사용자가 아이템을 클릭할지를 예측하는 Engagement Task와 사용자가 이 아이템에 대해 높은 평점을 줄지를 예측하는 Satisfaction Task이다. 이들 Task를 각각 수행하기 위해 별도의 모델로 나눠 각각 학습을 시킬 수도 있다.
그러나 우리가 실제로 가지고 있는 유저 로그는 전체 데이터에 비해 굉장히 희소하다. YouTube를 생각해봐도 하루에 올라오는 전체 동영상 중 내가 얼마나 클릭하는지를 생각해보면 짐작이 갈 것이다.
그래서 이 희소한 데이터를 가지고 효과적으로 학습할 방법을 생각하게 된다. 그 중 하나는 저 Task들의 관계를 생각해보는 것이다. 유저는 사실 이미 어느 정도 관심이 있는 아이템에 대해 클릭을 할 것이고, 그러면 자연히 해당 아이템을 좋아할 가능성이 높다. 즉, 이 두 Task는 서로 독립적인 Task가 아니라는 것을 알 수 있다.
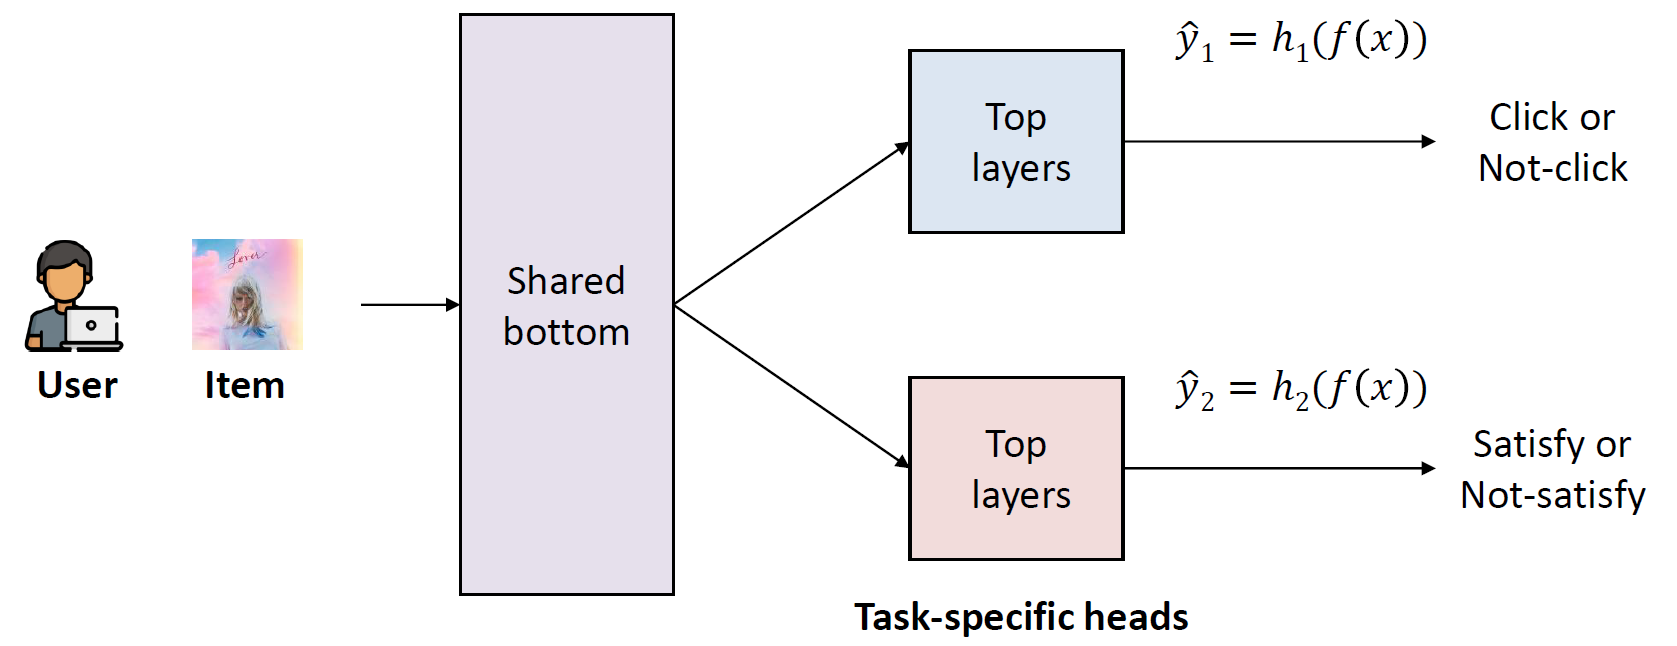
그렇다면 저렇게 분리된 Task를 각각 처리하기보다는 위 사진과 같이 공통의 Bottom Layer를 두고 그 위에 각 Task를 수행하는 Head를 두는 것이 더 효율적일 것이다.
이렇게 서로 다른 Task 간의 지식을 명시적으로 공유하는 구조를 가지게 해서, Label의 희소성을 어느 정도 완화하려는 방법이 바로 Multi-task Learning(MTL)이다. 보다 구체적으로, 하나의 모델이 여러 관련된 Task를 동시에 처리하도록 훈련하는 학습 패러다임을 의미한다.
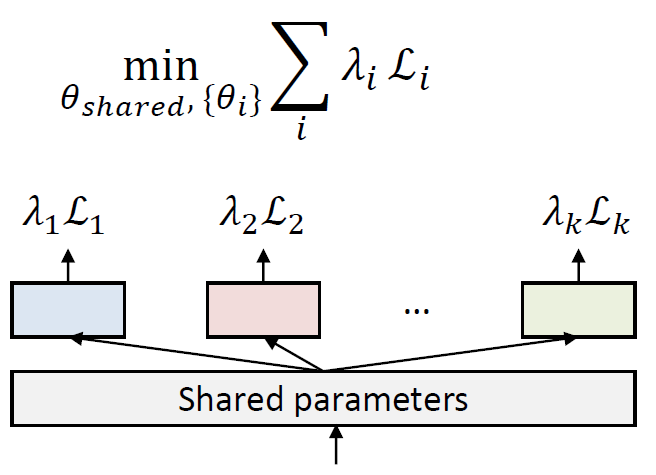
그래서 위 사진과 같이 모든 Task의 Loss를 전부 합한 공통된 Loss 하나를 한번에 최적화한다. 이러한 방식을 통해 서로 다른 Task 간의 일반화, 그리고 Label 부족 현상을 완화하기를 기대한다.
그러나 실제로는 Negative Transfer라는 문제가 발생한다. 이는 이름 그대로 Multi-task Learning을 적용하지 않는 것보다 성능이 오히려 떨어지는, 부정적인 전이가 일어나는 현상을 의미한다. 이러한 현상은 주 원인은 Task Discrepancy라고 불린다. 이는 서로 다른 Task 간의 근본적인 한계가 존재할 수 밖에 없어서 그 “근본적인 차이”가 크다면 한번에 학습시키는 것이 오히려 손해가 된다는 내용이다.
Multi-gate Mixture-of-Experts
이 Negative Transfer 문제를 해결하기 위한 기법 중 하나가 Multi-gate Mixture-of-Experts(MMoE)이다. MMoE는 Task Discrepancy 문제가 일어나는 Task 간의 근본적인 한계를 인정하고, 이들의 관계를 반영하자는 아이디어에서 출발한다.
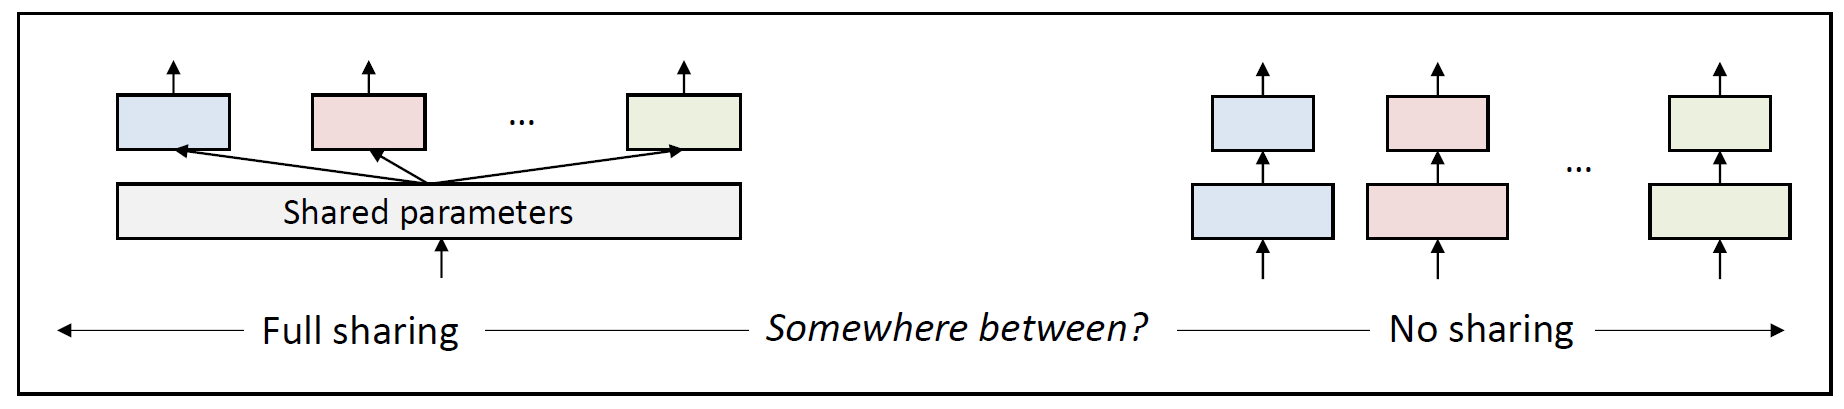
그 전에 먼저 Task 간의 관계에 대해 생각해보자. 위 사진에서 오른쪽의 구조는 “No Sharing” 상태로, 각 Task가 서로 독립적으로 각자의 모델을 갖고 따로따로 훈련되는 상태이다. 반대로 왼쪽의 구조는 “Full Sharing”으로, 모든 Task가 공통의 Shared Layer를 갖는 형태이다. 즉 이 형태는 가장 강력한 형태의 Sharing이라 Task Discrepancy 문제가 발생하는 것이다.
그렇다면 우리가 취해야 할 구조는 이들의 중간 상태이다. 즉 적절히 Sharing된 상태를 원하며, 보다 근본적으로는 대상으로 하는 Task 간의 Similarity에 따라 그 Sharing의 정도를 조절하고자 한다.
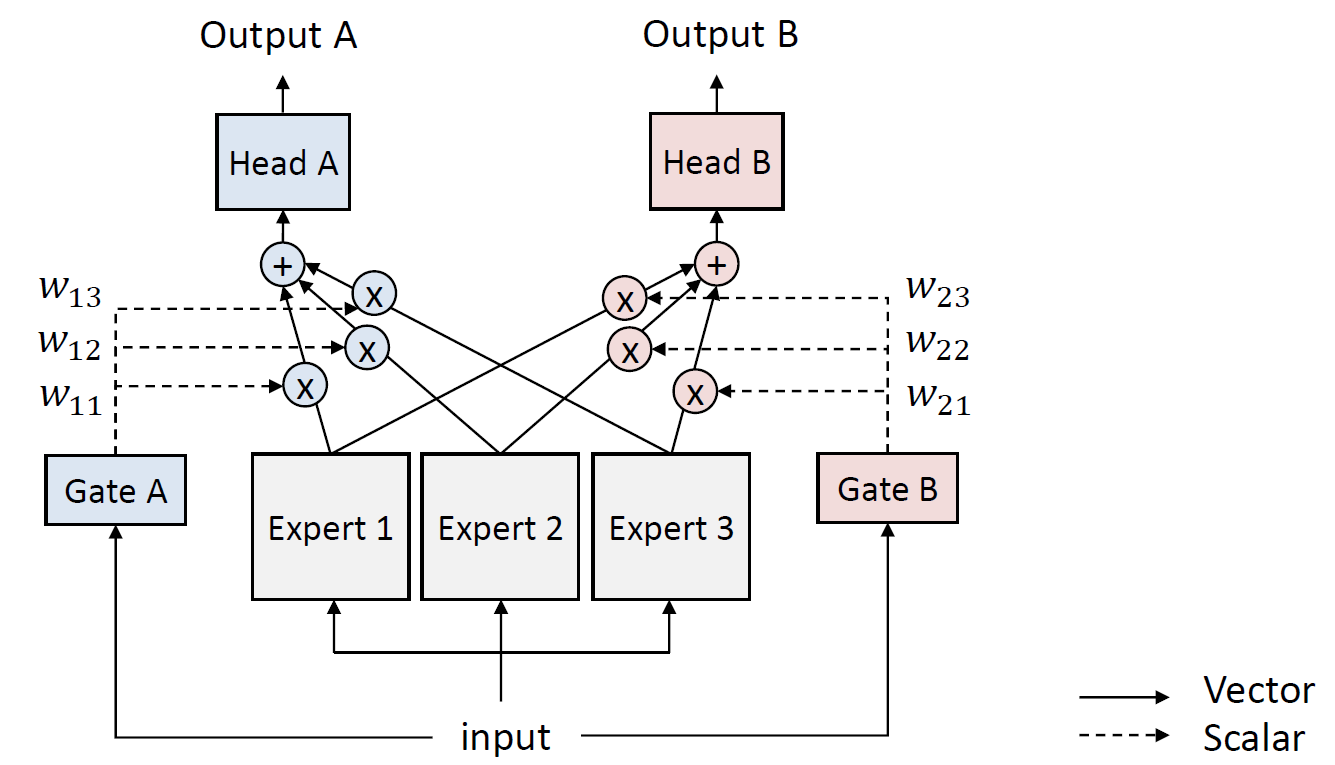
위 사진이 바로 MMoE의 구조이다. 우선 Shared Layer 대신 그 자리에 여러 개의 Subnetwork가 있는 것을 확인할 수 있다. 이들을 Expert라고 부른다. 이 때 “Sub”network라는 이름답게 이들 Expert의 파라미터 수의 총합이 Full Sharing 상태의 Shared Layer의 파라미터와 비슷하게끔 조절한다.
그리고 각각의 Task마다 이들 Expert로부터 영향받을 가중치가 계산된다. 즉, 각 Task별로 어느 Expert가 중요하게 봐야 하는지가 각 Task마다 다르게 설정된다. 이 가중치는 Gate라고 부르는 별도의 Network를 통해 학습된다.
이러한 구조를 취하면 각각의 Task가 반영해야 할 가중치조차 Data를 통해 학습되므로, Task 간의 관계도 동적으로 반영하게 된다. 즉, 만일 Task들이 유사하다면 그들의 Gate는 각각 비슷한 가중치를 리턴할 것이고 이는 곧 Sharing이 더 많이 된다는 것을 의미한다. 반대로 Task들이 별로 유사하지 않다면 Gate로부터 얻은 가중치가 다르게 나올 것이므로 Sharing도 적게 되는 형태가 된다.
그러면 이러한 구조에서, 각각의 Expert들은 어떻게 Input의 다른 부분을 학습할 수 있을까? 이는 Optimization 관점으로 해석할 수 있다.
학습하는 중 각 Parameter들은 Loss를 최소화하는 방향으로 업데이트가 된다. Gate도 별도의 Network니까 예외는 아닌데, 이는 곧 Gate A는 Task A의 Loss를 최소화하는 방향으로 학습하게 된다. 그런데 Gate A가 택할 수 있는 것은 각 Expert의 중요도뿐이다. 즉, Gate A는 Task A의 Loss를 최소화할 수 있는 지식을 갖는 Expert를 선택하도록 학습하게 된다. 이러한 행동이 각각의 Task에 대해 모두 적용된다.
그러면 이렇게 각 Gate가 선택한 Expert를 생각해보자. Task A에 대해서 Gate A가 Expert 1을 선택했다고 가정하면, 이는 곧 Expert 1은 다른 Expert들보다 Task A를 더 중점적으로 보도록 훈련이 되었다는 의미가 된다. 즉, Expert 1은 Task A Specific한 점을 찾아내도록 훈련되었다는 이야기가 된다.
이러한 과정이 학습이 진행되는 동안 전반적으로 계속해서 이루어지게 된다. 즉, Gate는 가장 좋을 것 같은 Expert를 선택하고, 그 선택받은 Expert는 그 Task를 가장 잘 하기 위해서 훈련하는 식의 순환이 반복되면서 점점 Expert가 이름 그대로 전문화되는 것이다. 이 방향이 전체 Loss를 최소화하는 방향이기 때문이다.