Deep Reinforcement Learning 6 - Model-free Control (2)
Before starting
“Class” 카테고리에 있는 포스팅들은 실제로 수업에서 배운 내용을 정리하려는 목적으로 작성되었다. 이 글은 그 중 Deep Reinforcement Learning 과목의 수업을 다룬다.
Off-policy Learning
저번 글에서 다뤘던 Model-free Control 방법들은 On-policy Learning에 속한다. On-policy Learning은 우리가 학습하고자 하는 Target Policy와 Sampling을 통해 경험을 쌓는 Behavior Policy가 동일한 경우를 의미한다.
이와는 반대되는 경우, 즉 Behavior Policy와 Target Policy가 서로 다른 경우를 Off-policy Learning이라고 한다. 이 경우 우리의 목표는 $V_\pi(s)$나 $Q_\pi(s,a)$를 계산하기 위해 Target Policy $\pi(a\vert s)$를 Evaluate해야 하지만, Episode는 Behavior Policy $\mu(a\vert s)$로부터 Sampling한다.
\[\lbrace S_1,A_1,R_2,\cdots,S_T\rbrace\sim\mu\]Episode를 Sampling하는 Policy가 다르다는 점 외에는 On-policy Learning과 동일하다. 이러한 Off-policy Learning은 실제로 여러 방면에서 유용하게 사용된다. 예를 들어서 전문가, 혹은 다른 에이전트들이 어떻게 하는지를 보고 배울 수 있고, 과거에 생성된 Policy들이 생성했던 경험들 재사용할 수도 있다. 혹은 Exploratory Policy를 통해 다양한 State를 탐험하고 이를 통해 다양한 경우를 찾아 Optimal Policy를 찾거나, 혹은 하나의 Behavior Policy를 통해 여러 개의 Policy를 학습할 수도 있다.
이와 같이 Behavior Policy와 Target Policy가 분리됨으로써 얻는 장점이 상당히 많다.
Importance Sampling
Off-policy Learning을 위해서는 우선 다른 분포를 따라 취한 Action을 통해 현재의 Expectation을 계산하는 방법이 필요하다. 이를 Importance Sampling이라고 하며, 아래와 같이 계산할 수 있다.
\[\begin{aligned} \mathbb{E}_{X\sim P}[f(X)]&=\sum P(X)f(X) \\ &=\sum Q(X)\dfrac{P(X)}{Q(X)}f(X) \\ &=\mathbb{E}_{X\sim Q}\left[\dfrac{P(X)}{Q(X)}f(X)\right] \end{aligned}\]즉, 분포 $P$와 $Q$의 비율을 곱함으로써 다른 분포의 Expectation을 계산할 수 있다.
Off-policy Monte-Carlo
이제 Importance Sampling을 이용해 Off-policy Monte-Carlo를 진행해보자. 위에서도 언급했듯이 Target Policy $\pi$를 Evaluate하기 위해 Behavior Policy $\mu$를 통해 생성되는 Return을 사용하게 된다.
Importance Sampling을 이용하면 특정 State $S_t$ 및 Action $A_t$에서의 Reward를 보정하기 위해서는 이 두 Policy의 비율, 즉 $\dfrac{\pi(A_t\vert S_t)}{\mu(A_t\vert S_t)}$를 곱하면 된다. MC에서는 Return을 사용하기 때문에 이러한 비율이 $t$ 이후의 모든 Time Step에 대해 존재하며, 따라서 다음과 같다.
\[G_t^{\pi/\mu}=\dfrac{\pi(A_t\vert S_t)}{\mu(A_t\vert S_t)}\cdot\dfrac{\pi(A_{t+1}\vert S_{t+1})}{\mu(A_{t+1}\vert S_{t+1})}\cdots\dfrac{\pi(A_T\vert S_T)}{\mu(A_T\vert S_T)}\cdot G_t\]그 이후의 과정은 On-policy MC와 동일하다. 즉, Value Function을 다음과 같이 업데이트한다.
\[V(S_t)\leftarrow V(S_t)+\alpha(G_t^{\pi/\mu}-V(S_t))\]그러나 실제로 Off-policy MC를 진행하면 몇 가지 문제가 발생하게 된다. 우선 $\mu$가 0이 된다면 위의 값은 계산이 불가능해진다. 또한 MC는 기본적으로 Variance가 큰 방법인데, 여기서는 2개의 Policy를 따라서 계산하기 때문에 그 Variance가 더욱 커지게 된다.
Off-policy Temporal-Difference
Off-policy Temporal-Difference 역시 Importance Sampling을 이용해 진행할 수 있다. TD에서는 MC와 달리 한 번의 Step만을 고려하기 때문에 TD target이 $R_{t+1}+\gamma V(S_{t+1})$ 대신 다음의 식으로 바뀌게 된다.
\[\dfrac{\pi(A_t\vert S_t)}{\mu(A_t\vert S_t)}(R_{t+1}+\gamma V(S_{t+1}))\]이 식을 On-policy TD에 그대로 적용하면 된다. 즉, Value Function을 다음과 같이 업데이트한다.
\[V(S_t)\leftarrow V(S_t)+\alpha\left(\dfrac{\pi(A_t\vert S_t)}{\mu(A_t\vert S_t)}(R_{t+1}+\gamma V(S_{t+1}))-V(S_t)\right)\]이 경우 MC와 달리 한 번의 Step만을 고려하기 때문에 Variance가 늘어날 위험 또한 크게 줄어들게 된다. 따라서 MC에 비해 Variance를 낮출 수 있다는 점은 Off-policy에서도 동일하다.
Q-Learning
위에서 보다시피 Importance Sampling을 통한 Off-policy 방법은 기존 On-policy Learning에서도 사용했던 MC와 TD를 거의 그대로 적용할 수 있지만, 대신 Policy 2개의 분포를 동시에 다뤄야 하기 때문에 안 그래도 Variance가 높아서 문제인 방법들의 Variance를 더욱 높인다는 문제가 발생한다.
이러한 문제를 해결하기 위해 Importance Sampling을 사용하지 않고 Off-policy Learning을 수행할 새로운 방법을 찾게 되었고, Q-Learning이 그 중 하나이다. Q-Learning은 Action Value Function $Q(s,a)$를 이용한 학습 방법으로, 기본적으로 Off-policy Learning이기에 여기서도 Behavior Policy $\mu$와 Target Policy $\pi$가 정의된다.
이제 State $S_t$에서 취해야 할 Action을 생각해보자. 우리는 이 상황에서 Behavior Policy $\mu$를 통해 다음 Action을 결정하므로, 이 값은 $A_{t+1}\sim\mu(\cdot\vert S_{t+1})$이 된다. 그러나 실제로 학습해야 할 Target Policy $\pi$는 $A^{\prime}\sim\pi(\cdot\vert S_{t+1})$이다. 그래서 아래와 같이 Target Policy로부터 얻은 $Q$값을 이용해 업데이트한다.
\[Q(S_t,A_t)\leftarrow Q(S_t,A_t)+\alpha(R_{t+1}+\gamma Q(S_{t+1},A^{\prime})-Q(S_t,A_t))\]위 식을 보면, 받는 Reward 및 진행하는 State는 Behavior Policy를 따랐을 때의 Reward 및 State인데, 정작 어떤 Action을 취할지에 대한 예측은 Target Policy를 따르고 있다. 이를 통해 다음 State의 $Q$를 예측하고, 이를 이용해 TD Target을 구성한다고 생각할 수 있다. 실제로 On-Policy Learning이라면 $A^{\prime}=A_{t+1}$이므로, 위 식은 그대로 SARSA가 된다.
이렇게 TD Target의 $Q$ 값을 Target Policy $\pi$를 따르게 바꿈으로써 Importance Sampling을 아예 사용하지 않고도 Off-policy Learning을 수행할 수 있다.
Off-policy Control
그러면 Q-Learning을 이용한 Off-policy Control은 어떻게 진행될까? 우선 다뤄야 하는 Policy가 2개이므로 이들을 따로 생각해야 한다. Target Policy $\pi$의 경우 당연히 greedy하게 구성해야 한다.
\[\pi(S_{t+1})=\arg\max_{a^{\prime}}Q(S_{t+1},a^{\prime})\]위와 같이 greedy하게 $Q$를 최대화하는 식으로 $\pi$를 취하면 된다.
Behavior Policy의 경우는 Target Policy와 유사한 Policy를 만드는 것이 최선이다. 다만 Target Policy와 동일하게 greedy하게만 구성하면 Exploration이 전혀 이루어지지 않기 때문에, Behavior Policy에서 $\epsilon$-greedy를 적용해 Exploration이 이루어지게 한다.
또한 이제 Q-Learning에서의 TD Target도 아래와 같이 정리된다.
\[\begin{aligned} R_{t+1}+\gamma Q(S_{t+1},A^{\prime})&=R_{t+1}+\gamma Q\left(S_{t+1},\arg\max_{a^{\prime}}Q(S_{t+1},a^{\prime})\right) \\ &=R_{t+1}+\gamma\max_{a^{\prime}}Q(S_{t+1},a^{\prime}) \end{aligned}\]이는 $A^{\prime}$이 곧 $Q(S_{t+1},a^{\prime})$을 최대화하는 Action이기 때문에, 그대로 $Q(S_{t+1},a^{\prime})$의 최댓값이 들어가게 되기 때문이다.
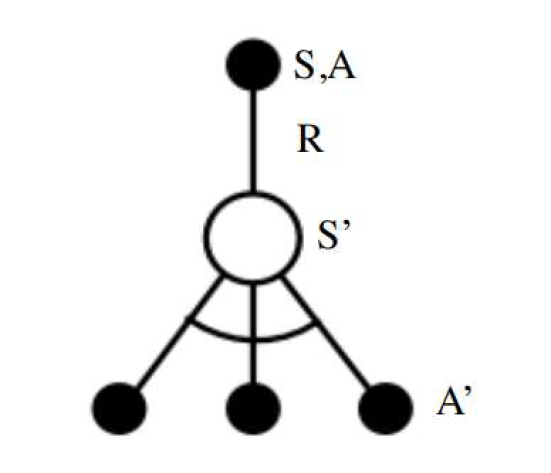
따라서 Control 문제는 TD에서의 SARSA와 유사한 형태로 되지만, $\max$값이 추가된다는 점이 다르다.
\[Q(S,A)\leftarrow Q(S,A)+\alpha(R+\gamma\max_{a^{\prime}}Q(S^{\prime},a^{\prime})-Q(S,A))\]즉, SARSA에서 확장된 형태가 되며, 이를 SARSA Max라고도 부른다. Q-Learning Control은 이 SARSA Max를 이용해 업데이트를 수행하게 된다. 위의 식은 결국 Policy Evaluation과 Policy Improvement가 합쳐진 상태로 간소화된 형태이며, 이 $\max$값은 또 Bellman Optimality Equation에서 온 표현으로도 해석할 수 있다.