Text Mining 4 - Classification Task
Before starting
“Class” 카테고리에 있는 포스팅들은 실제로 수업에서 배운 내용을 정리하려는 목적으로 작성되었다. 이 글은 그 중 Text Mining 과목의 수업을 다룬다.
Text Classification
이전 글들을 통해 텍스트를 vector로 변환하는 방법을 배웠다. 이제 수학적으로 다룰 준비가 끝난 셈인데, 이걸로 가장 먼저 해야 하는 작업은 바로 Classification이다.
이 Classification은 간단해 보이지만 생각보다 더 중요한 작업인데, text에 내재된 Predefined label을 예측하는 문제로 볼 수 있기 때문이다. 한 텍스트가 일괄적으로 하나의 분류에만 해당될 수는 없다. 경우에 따라선 Brand 기준으로도 나눠야 하고, Product 기준이나 Sentiment 기준으로도 나눠야 한다. 그 외에도 QA나 검색 엔진, 대화형 시스템 등 Classification은 텍스트를 다루는 모든 분야에서 가장 기반이 되는 Task라고 할 수 있겠다.
Pretraining & Fine-tuning
Classification Task를 다루기 전에, 먼저 Pretrain-and-fine-tune paradigm에 대해 알아보자.
만일 언어 모델을 새로 만들어야 한다고 가정해보자. 그러면 이 모델에게는 먼저 자연어부터 학습시켜야 하고, 이를 위해선 웹상에 존재하는 대부분의 텍스트 데이터를 통한 학습이 선행되어야 한다. 그러나 잘 생각해보면 이 작업 자체는 이미 많이 이루어졌고, Word2Vec이나 BERT같이 그 결과물까지 공개되어 있는 경우도 상당히 많다. 즉, 이를 다시 처음부터 시작하는 것은 상당히 비효율적이다. 그래서 이러한 “일반적인 지식들”을 미리 녹여놓아서, Human Labeling 없이도 General purpose representation을 낼 수 있는 일반적인 모델을 먼저 훈련하는 방식을 취하는데, 이것이 Pretraining이다.
이렇게 Pretrain된 모델을 가져다가 내가 원하는 작업을 하게 하려면, 이제서야 비로소 내 작업에 맞는 Labeling 및 Training이 필요하게 된다. 이 과정은 완전히 초기화된 모델을 학습하는 것이 아니라 이미 있는 모델의 가중치를 약간만 조정하는 작업이기 때문에, Fine-tuning이라고 부른다. 제 아무리 규모가 큰 작업이더라도 위에서 이미 학습해놓은 “일반적인 지식들”에 비해서는 적을 수 밖에 없기 때문이다. 이 때 내가 원하는 그 작업을 Downstream task, 혹은 Target task라고 부른다.
이러한 방식은 다시 처음부터 모든 것을 훈련시켜야 하는 데서 오는 비효율성 외에도, Gradient Descent 관점에서 봐도 꽤 효율적이다. 이는 Pretrain 된 모델은 상당히 좋은 출발점을 제공해 주기 때문이다.
한 가지 예시로, Sentiment classification 문제를 푼다고 가정해보자. 이를 위해 Pretrained 된 모델을 고르는데, 여기선 BERT를 골랐다.
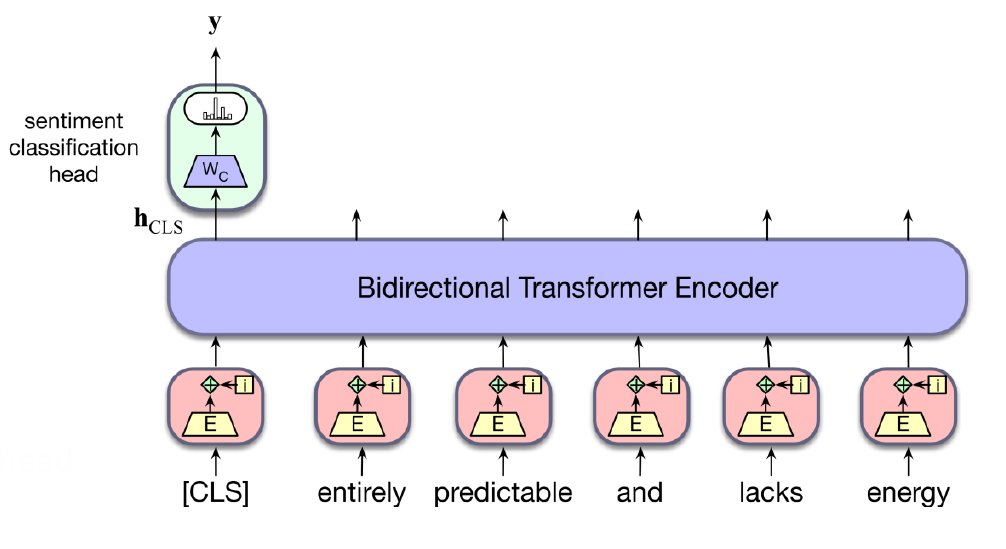
BERT는 [CLS] token이 존재해서 이 token을 확인하여 모든 다른 contextual embedding을 종합한 정보를 얻을 수 있다. 따라서 우리가 원하는 Classification Task를 위해서는, 이 [CLS] token을 input으로 하는 새 head를 붙이면 된다.
또한 어떤 식으로든 파라미터를 업데이트 해야 하는데, 여기엔 두 가지 선택지가 있다. Full fine-tuning은 말 그대로 모든 파라미터를 전부 업데이트 하는 것이다. 이와 대비되는 방법으로 일부만 업데이트하는 Partial fine-tuning 방법이 있다.
아무리 Fine-tuning이더라도 모든 파라미터를 건드리려면 그에 걸맞는 양의 데이터 및 연산력이 필요하다. 그래서 연산력이 받쳐주지 않는 상황이라면 Partial fine-tuning을 하게 되며, 이 중에서도 Head만 업데이트하는 방법, 혹은 극소수의 Encoder까지 같이 업데이트하는 방법이 있다. 후자의 경우는 보통 상위 Layer를 건드는 편인데, 상위 Layer로 올라갈수록 더 심화된, 복잡한 context를 담기 때문이다.
Classification Task
이제 본 주제인 Classification으로 돌아와보자. Classification을 한 문장으로 정의하면 “Input data를 Predefined category의 집합 $C$의 원소들로 예측하는 것”이라고 할 수 있다. 이 $C$의 크기 $\vert C\vert$에 따라 $\vert C\vert=2$인 Binary Classification과 $\vert C\vert\gt2$인 Multi-class Classification으로 나눌 수 있다.
앞서 보았던 fine-tuning을 위한 예시처럼, 이 과정을 위한 작은 Head, 즉 Classifier를 모델 뒤에 붙이는 형태를 이루게 된다.
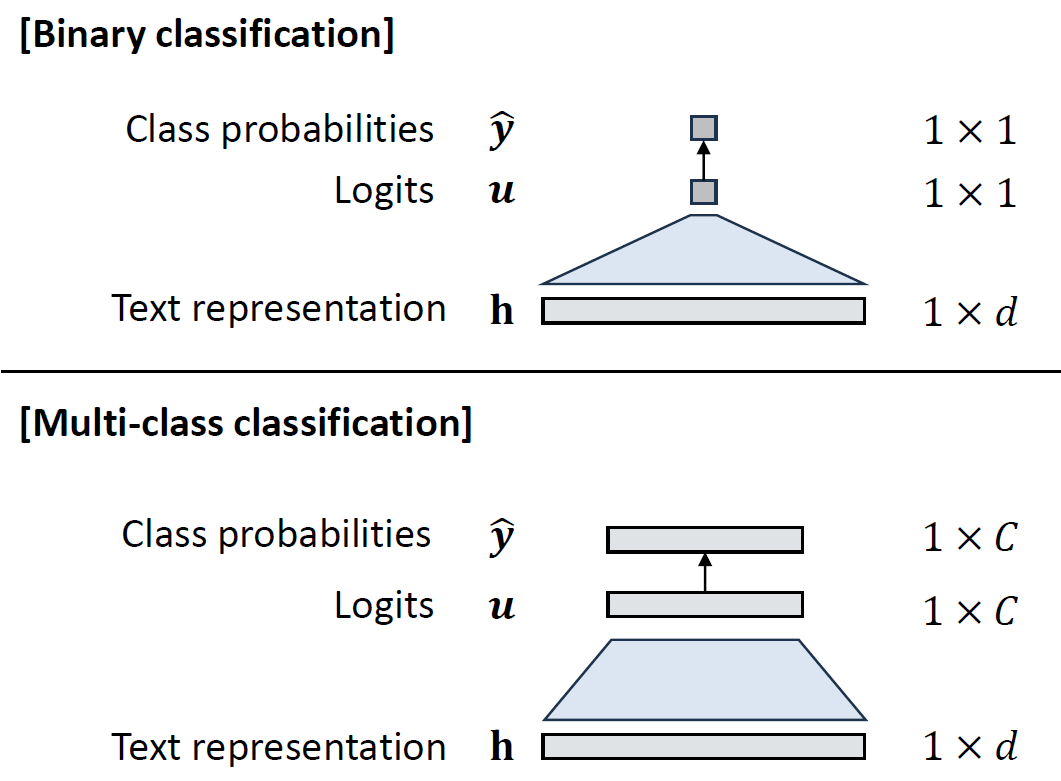
이 때 이 두 과정은 기본적으론 거의 유사하다. 차이점은 어떤 함수를 사용하느냐, 그리고 $\hat{y}$의 크기가 어떻게 되느냐 정도이다. Binary classifier의 경우엔 Sigmoid를 사용하며 $\hat{y}$는 $1\times1$ 크기가 된다. Multi-class classifier의 경우엔 클래스의 개수 $C$에 따라 $\hat{y}$의 크기가 $1\times C$가 되고, Softmax를 사용한다.
각각의 Loss function 또한 유사하게 정의된다.
먼저 Binary classification부터 보자. 데이터셋 $\mathcal{D}=\lbrace(x_n,y_n)\vert n=1,\ldots,N},\,y_i\in{0,1\rbrace$이라고 할 때, 각각의 Label은 Bernoulli Random Variable로 모델링된다. 즉, 이 Dataset의 Likelihood는 다음과 같다.
\[\prod_{n=1}^{N}\hat{y}_n^{y_n}(1-\hat{y}_n)^{1-y_n},\quad \hat{y}_n=p(y_n=1\vert x_n)\]이 Likelihood가 최대화가 되어야 하므로, 아래와 같이 Negative Log Likelihood를 취해서 이를 최소화한다.
\[\mathcal{L}_{BCE}(\theta)=-\sum_{n=1}^{N}\left[y_n\log\hat{y}_n+(1-y_n)\log(1-\hat{y}_n)\right]\]이 Loss function을 Binary Cross Entropy(BCE)라고 부른다.
이제 Multi-class classification의 경우는 다음과 같다. 데이터셋 $\mathcal{D}=\lbrace(x_n,y_n)\vert n=1,\ldots,N},\,y_i\in{1,\ldots,C\rbrace$이라고 할 때, 각각의 Label은 이번엔 Categorical Random Variable로 모델링된다. 즉,
\[P(y_n=c\vert x_n)=\hat{y}_{n,c},\quad\sum_{c=1}^{C}\hat{y}_{n,c}=1\]이 때 이 Dataset의 likelihood는 다음과 같다.
\[\prod_{n=1}^{N}\prod_{c=1}^{C}\hat{y}_{n,c}^{1\left[y_n=c\right]}\]마찬가지로 Negative Log Likelihood를 취해서 이를 최소화하면 된다.
\[\mathcal{L}_{CE}(\theta)=-\sum_{n=1}^{N}\sum_{c=1}^{C}1\left[y_n=c\right]\log\hat{y}_{n,c}\]이 Loss function을 Cross Entropy(CE)라고 부른다.
여기서 한 가지 재밌는 점은, Binary classification의 경우에도 softmax를 사용할 수 있다. 보다 정확히 말하면, Class가 2개일 때의 softmax는 다음과 같이 sigmoid의 형태가 나온다.
\[p_1=\dfrac{e^{u_1}}{e^{u_0}+e^{u_1}}=\dfrac{1}{1+e^{u_0-u_1}}=\sigma(u_1-u_0)\] \[p_0=\dfrac{e^{u_0}}{e^{u_0}+e^{u_1}}=\sigma(u_0-u_1)=1-p_1\]즉, 두 logit의 차이 $u_1-u_0$에 대한 sigmoid 값이 나오게 되는데, 이는 Binary classification Task를 다른 관점에서 보는 것에 불과할 뿐이라 수학적으로는 사실상 동치와 다름없게 된다.
그리고 CE 또한 아래와 같이 BCE의 형태로 유도된다.
\[-\left[y\log p_1+(1-y)\log(1-p_1)\right]\]Multi-label Classification
그렇다면 Multi-label이라면 어떨까? 이 경우는 하나의 input이 여러 class에 동시에 속하는 경우를 말한다. 특히 텍스트에서 자주 일어나는 현상인데, 하나의 문장이 오로지 하나의 class에만 속한다고 가정할 수는 없다. 같은 텍스트더라도 제품 기준으로도 나눌 수 있고, 감정 기준이나 도메인 기준, 혹은 브랜드 기준 등 여러 기준에 따라 각각 다른 class의 소속이라고 볼 수 있다.
그래서 Multi-label Classification 상황도 다뤄야 하는데, 이 경우에는 다음과 같이 각 Label $y_c$에 대해 Independent Bernoulli Variable로 모델링한다.
\[P(y\vert x)=\prod_{c=1}^{C}\hat{y}_c^{y_c}(1-\hat{y}_c)^{1-y_c},\quad\hat{y}_c=P(y_c=1\vert x)=\sigma(u_c)\]그래서 Classifier의 구조 자체는 Multi-class Classifier와 동일하게, $\hat{y}$의 크기가 $1\times C$가 되지만 softmax 대신 sigmoid를 사용하는 형태가 된다.
이 경우에도 앞에서와 동일한 과정을 거쳐 다음과 같은 형태의 Loss function을 구할 수 있다.
\[\mathcal{L}_{\text{Multi-label}}(\theta)=-\sum_{n=1}^{N}\sum_{c=1}^{C}\left[y_{n,c}\log\hat{y}_{n,c}+(1-y_{n,c})\log(1-\hat{y}_{n,c})\right]\]Label이 여러개일 뿐 각각은 서로 독립적인 Bernoulli Random Variable이므로, 안의 형태는 앞에서 보았던 BCE가 그대로 나오게 된다.
이러한 경우는 어디까지나 각각의 개별 Class 간에 상호 배타적이지 않은 경우, 즉 전부 독립인 경우에 대해 적용 가능한 예시인 것이고, 만일 일부가 서로 배타적이라면 이들에 대해서는 softmax를 취해야 한다. 이 경우 당연히 그 배타적인 class들끼리의 확률의 합은 1이 되어야만 한다.
Evaluation
이렇게 Classifier를 구성해서 학습을 시켰다면, 이를 확인하고 성능을 평가할 방법이 필요하다.
먼저 Binary classification부터 확인해보자. Classifier의 성능을 평가하려면 다음의 두 가지를 파악해야 한다.
- 우리의 모델이 어떻게 예측을 했는지
- 우리의 모델이 어떻게 예측을 했어야 했는지
이들을 파악하고 비교하기 위해 다음과 같은 Matrix를 구성한다.
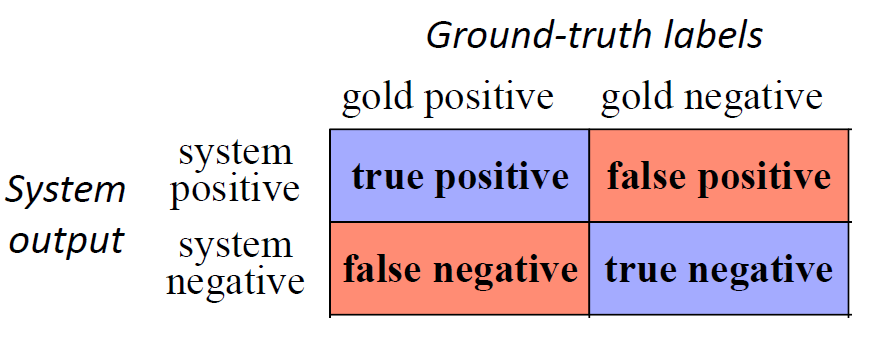
Confusion Matrix는 정답 Label (Ground-truth labels)와 모델이 예측한 Label (System output)을 비교하여, 위 사진과 같이 총 4개의 영역으로 나눈다.
이 Confusion Matrix를 바탕으로 크게 다음과 같은 지표들을 계산해서 사용한다.
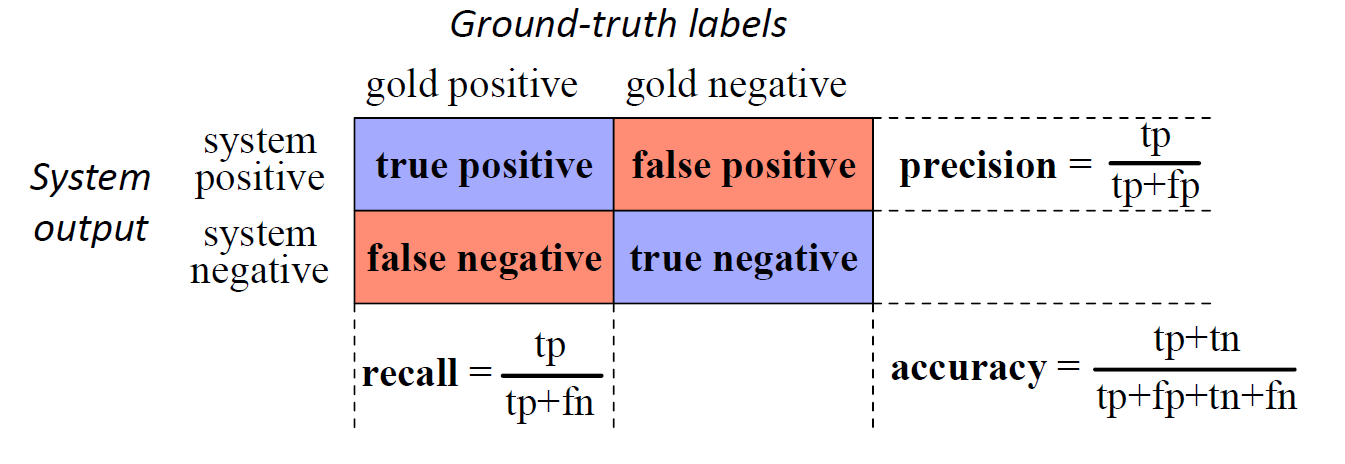
먼저 Accuracy는 모델이 올바르게 예측한 비율을 나타낸다.
\[\text{accuracy}=\dfrac{TP+TN}{TP+FP+TN+FN}\]일반적으로 성능이라고 하면 가장 먼저 떠오르는 지표이기도 하다. 그러나 각 Class 간의 비율이 불균형한 경우, Accuracy는 그리 좋은 지표가 아니게 된다.
예를 들어서 스팸 메일 분류 문제를 생각해보자. 스팸 메일의 비중은 일반적으로 굉장히 적기 때문에, 모든 메일을 스팸이 아니라고만 해도 Accuracy는 굉장히 높게 나오게 된다. 그렇다고 이 모델이 좋은 모델이라고 말할 수는 없을 것이다.
그래서 Accuracy를 보완해줄 다른 지표가 더 필요하다.
이를 위해 많이 고려되는 것이 Precision과 Recall이다.
\[\text{precision}=\dfrac{TP}{TP+FP},\quad\text{recall}=\dfrac{TP}{TP+FN}\]Precision은 예측된 Positive 중 실제로도 Positive인 것의 비율을, Recall은 실제 Positive 중 예측이 성공한 것의 비율을 의미한다.
이 둘은 각각 다른 관점에서 성능을 평가한다. Precision의 경우는 correctness, 즉 모델의 예측이 얼마나 정확한 정보를 담고 있느냐를 중심으로 보고, Recall의 경우는 coverage, 즉 모델이 얼마나 많은 Positive를 찾아냈느냐를 중심으로 본다.
재밌게도 이 둘은 동시에 최대화하기 어려운 trade-off 관계에 있다. 동일한 모델이어도 threshold를 통해 모델의 sensitivity를 조절할 수 있는데, threshold를 높이면 이 모델은 좀 더 엄격해지고 따라서 좀 더 확실한 데이터에만 Positive를 부여하게 된다. 즉 Precision이 올라가고, Recall이 내려가게 된다.
반대로 threshold를 낮추면 모델은 좀 더 관대해지고, 따라서 더 많은 데이터에 Positive를 부여하게 된다. 이는 위와는 반대로 Recall이 올라가고 Precision이 내려가게 된다.
그래서 이 두 지표를 동시에 고려하기 위한 하나의 지표가 필요하다. 이를 F1-Score라고 하며, 다음과 같이 Precision $P$와 Recall $R$의 조화 평균으로 계산한다.
\[F_1=\dfrac{2PR}{P+R}\]여담으로 F1-Score의 “1”은 이 지표가 Precision과 Recall을 1:1 비율로 고려한다는 의미에서 붙은 이름이다. 만일 Recall을 Precision에 비해 $\beta$배 중요하게 봐야 하는 상황이라면, 다음과 같은 $F_\beta$-Score를 사용하게 된다.
\[F_\beta=\dfrac{(1+\beta^2)PR}{\beta^2P+R}\]이는 $P$와 $R$의 가중 조화평균에서 온 것이다. 즉, F1-Score는 $F_\beta$-Score의 특수한 경우라고 볼 수 있다.
Multi-class Classification
그러면 Multi-class Classification이라면 어떨까? 이 경우에도 동일하게 Confusion Matrix를 구성하면 된다. 다만 $2\times2$가 아니라 $C\times C$의 크기를 갖게 될 뿐이다.
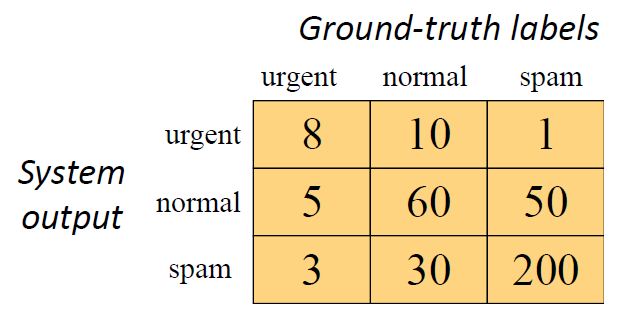
위 사진은 $C=3$인 경우의 Confusion Matrix를 나타낸다. 그러면 각각의 지표도 동일하게 계산할 수 있을까?
우선 Accuracy의 경우, Binary Classification과 동일하게, “전체 개수 중 대각선의 비율”로 계산하면 된다. 즉, 위의 예시라면 $(8+60+200)/367\approx0.730$ 정도가 나올 것이다.
하지만 Precision, Recall, 그리고 F1-Score의 경우는 이런 식의 통합된 지표보다는 각각의 Class에 대한 지표로 바꿔서 계산하게 된다. 즉, 위의 예시라면 “Urgent class”에 대한 Precision, Recall, F1-Score, “Normal class”에 대한 Precision, Recall, F1-Score, 그리고 “Spam class”에 대한 Precision, Recall, F1-Score를 각각 계산하게 된다.
그런데 결국 우리가 원하는건 이를 단일 지표로 합치는 것이다. 이를 위해 Macro-averaging과 Micro-averaging이라는 두 방법이 사용된다.
Macro-averaging은 간단하게 앞에서 구했던 Class별 지표를 각각 산술평균으로 통합하는 방법이다. 즉, Urgent에 대한 Precision, Normal에 대한 Precision, Spam에 대한 Precision을 전부 더해서 3으로 나눠 전체 Precision으로 취급하는 것이다. 이를 Recall과 F1-Score에 대해서도 수행한다.
Macro-averaging은 모든 class를 동일하게 취급한다. 즉, 각 class의 실제 비중을 전혀 고려하지 않는 지표이다. 그렇기 때문에 희소한 class가 존재한다면 그러한 측면을 더 잘 드러내준다는 장점이 있다. 그러나 반대로 이 모델의 전반적인 성능을 잘 드러내주지는 않는다. 앞서 말했듯 희소한 class가 실제보다 더 높게 가중되기 때문이다.
Micro-averaging은 조금 더 복잡한 방법을 취한다. 각 클래스에 대한 TP, TN, FP, FN을 계산한 후, 이들을 합해서 하나의 거대한 $2\times2$ Confusion Matrix를 구성한다.
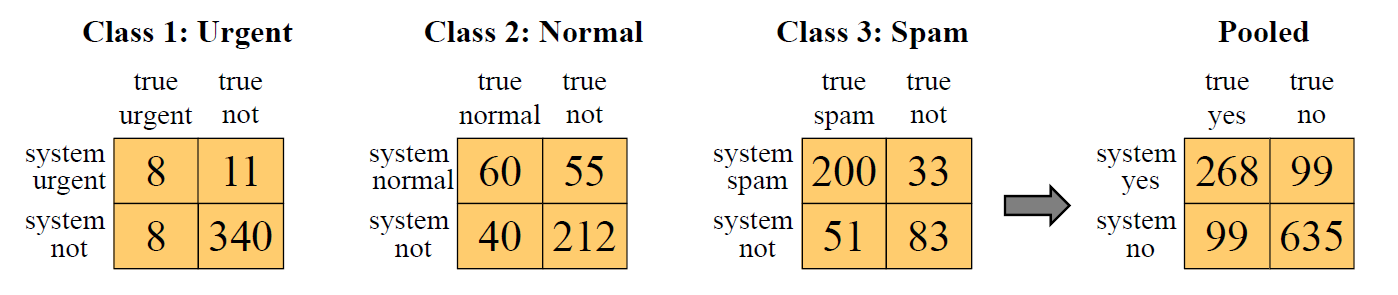
이렇게 구해진 $2\times2$ Confusion Matrix에서 Precision, Recall, F1-Score를 계산하는 것이다.
Micro-averaging은 Macro-averaging과 달리 전체 데이터에를 취합해서 계산하기 때문에 모델의 전반적인 성능을 잘 드러내준다. 그러나 바로 그 점으로 인해 instance가 많은 class의 성능이 전체 성능을 좌우하게 된다. 즉, 희소한 class에 대한 성능이 묻혀져서 잘 드러나지 않게 된다.
따라서 이들 두 지표는 어느 하나가 우월한 관계는 아니다. 데이터의 특성에 따라 Macro-averaging이 필요할 수도, Micro-averaging이 필요할 수도 있기 때문이다.