Deep Reinforcement Learning 1 - Intro
Before starting
“Class” 카테고리에 있는 포스팅들은 실제로 수업에서 배운 내용을 정리하려는 목적으로 작성되었다. 이 글은 그 중 Deep Reinforcement Learning 과목의 수업을 다룬다.
Three Types of ML
ML은 크게 3가지로 나눌 수 있다. Supervised Learning, Unsupervised Learning, 그리고 Reinforcement Learning이다.
Supervised Learning은 ML 중 가장 대표적이라고 할 수 있는데, Input과 Output이 모두 존재하는 Dataset을 기반으로 학습을 할 때 사용한다. 일반적으로 Output, 즉 Label이 존재하는 데이터셋에서 진행할 수 있으며, Classification과 Regression이 대표적인 분야다. 이 둘은 예측하는 결과가 Discrete한지 Continuous한지로 구분할 수 있다.
Unsupervised Learning은 Supervised Learning과 다르게 Input만 존재하는 Dataset을 사용한다. 이 Input을 분석해서 어떠한 정보를 뽑아내는 형태의 학습을 진행하는데, 대표적으로 Clustering, Dimensionality Reduction 등이 이 부류에 속한다.
Reinforcement Learning은 이 둘과는 많이 다른 형태의 학습이다. Reinforcement Learning에서는 모델이 어떤 행동을 취할 때마다 받는 Reward를 기반으로 학습을 진행한다. 즉 Reward를 잘 받으면 그 행동을 더 자주 하게 될 것이고, 반대로 Reward가 좋지 않으면 그 행동을 잘 안 하는 형태가 될 것이다. 이러한 류의 학습은 시행착오를 겪으면서 경험을 쌓을 수 있는 분야에 적용하기 쉬우며, 대표적인 예시가 바로 게임이다. 그 외에도 로봇 공학이나 Real-time decision 등이 필요한 형태에서도 많이 사용한다.
Reinforcement Learning
이제 이 Reinforcement Learning에 대해 알아보자.
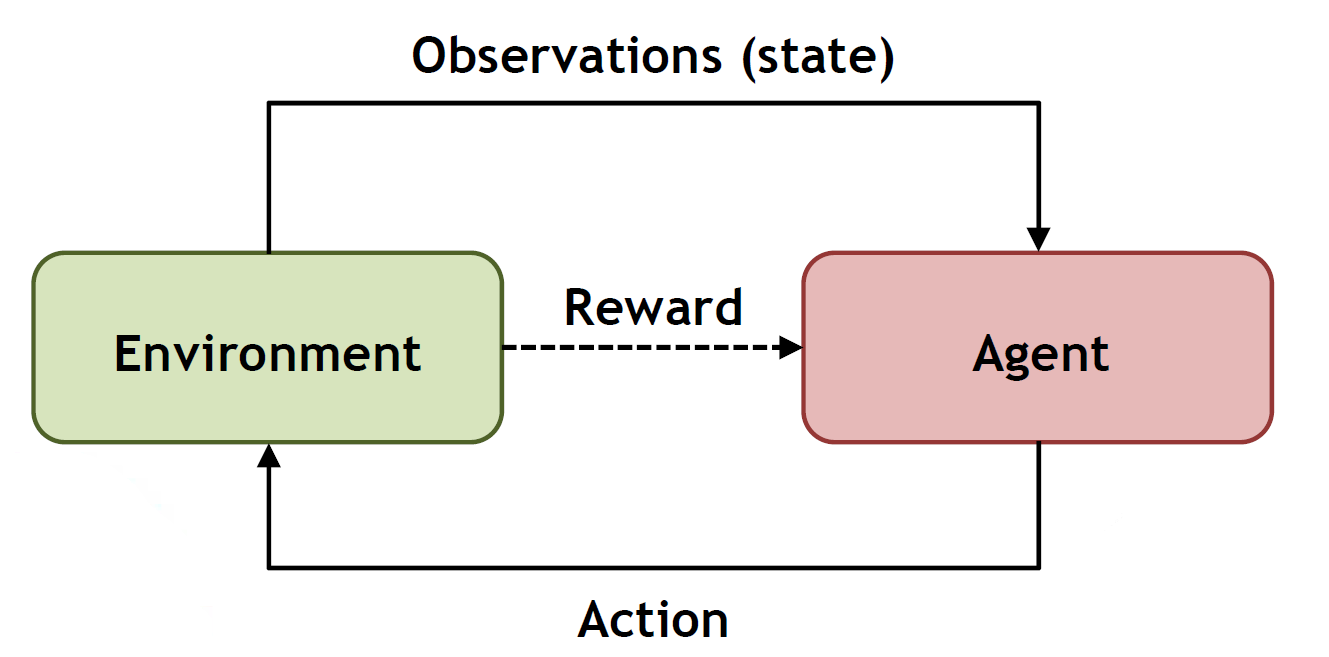
Reinforcement Learning의 전반적인 구조는 위 사진과 같다. 크게 Environment와 Agent로 구성되어 있는데, Environment는 모델이 동작을 수행하는 배경/환경 자체를 의미한다. 게임을 예로 들자면 그 게임에서 허용되는 액션들이나 게임의 규칙 등이 전부 Environment에 해당한다. 그리고 Agent는 이러한 Environment에서 플레이하는 플레이어가 된다.
Environment와 Agent는 서로 상호작용을 하게 된다. 먼저 Agent는 본인에게 주어진 Environment가 어떠한 규칙을 갖고 있고 현재 State가 어떤지를 파악해야 한다. 이를 Observation이라고 부른다. 현재 State에 대한 Observation이 완료된 뒤, Agent는 Environment 내에서 적절한 Action을 취하게 되고, 그에 따라 Environment의 State가 변경되어 그를 다시 관측하고 Action을 취하는 과정이 연속적으로 일어나게 된다.
이러한 일련의 Sequence가 진행되는 중에, 각각의 Action에 대한 결과가 Reward로써 주어지게 된다. Agent는 이 Reward를 통해 본인의 Action을 판단할 수 있으며, 따라서 모델은 이 Reward의 합을 최대화하는 방향으로 학습하게 되는 것이다.
Components of RL
게임에서는 위에서 언급했던 Environment, Agent, State, Action, Reward가 명확히 존재한다. 하지만 게임이 아닌 상황에서는 이러한 것들이 명확하게 정의되지 않은 경우가 많으며, 따라서 이들을 분리해서 정의하는 것이 첫 번째 과제가 된다.
위의 구성요소에서 필수적인 것들을 나열해보면 다음과 같은 Sequence가 된다.
\[S_0A_0R_1S_1A_1R_2\cdots S_tA_tR_t\cdots\]여기서 $S_t$는 State를 의미하며, 주어진 Environment 내에서 다음에 무슨 일이 일어날지 충분히 예측 가능한 구조로 정의되어야 한다. 일반적으론 vector 형태로 정의되겠지만 위의 조건에만 맞으면 다른 형태의 구조로도 정의될 수 있다.
$A_t$는 Action을 의미하며, 명확한 동작을 정의할 수만 있으면 어떠한 형태여도 상관없다. 다만 일반적으론 Environment 내에서 허용된 Action을 선택해야 하므로, Environment를 정의하게 되면 그에 따라 Action Space도 자연스럽게 정의되게 된다.
$R_t$는 Reward를 의미하며, Scalar로 정의된다. Reinforcement Learning의 목적이 바로 이 Reward의 총합, Total Reward를 최대화하는 것이다. 다만 Reward는 즉각적으로 나타나진 않을 때도 있다. 바둑을 예로 들면 한 수마다 즉시 점수를 매길 수 없는 경우가 더 많고 경기가 끝난 후 복기를 할 때 비로소 그 수가 얼마나 좋았는지 계산이 가능할 것이다. 이와 같이 Reward는 즉시 나타나지 않고 delay될 수 있다.
또한 강화학습의 어려운 점 중 하나로, Agent는 Environment의 모든 지식을 다 알 수 있는 것은 아니기도 하다. 게임을 생각해봐도 플레이어가 관여하지 않은 부분에서 다른 상호작용이 충분히 일어날 수 있으며, 이를 플레이어가 즉각적으로 눈치채지 못하는 경우도 많다. 이것이 그대로 Reinforcement Learning에서도 적용된다고 생각하면 된다.
Reinforcement Learning의 또다른 중요한 요소 중 하나로 Policy가 있다. Policy는 현재 State에서 Agent가 취할 수 있는 Action들 중 어느 것을 고를지 정하는 함수로, $\pi$로 표현한다. 만일 Deterministic하게 결정되는 경우라면 $a=\pi(s)$로, Stochastic한 상황이라면 $\pi(a\vert s)=\mathbb{P}(A_t=a\vert S_t=s)$로 표현한다.
그리고 Value Function이라는 개념도 등장한다. Value Function은 현재 State가 얼마나 좋은지 판단하는 함수로, 만일 State만 보고 판단할 경우에는 State Value Function으로, 현재 State에서 어떤 Action을 수행하는 것이 좋은지를 판단할 경우에는 State Action Value Function으로 부른다.
그런데 여기서 “좋다”는게 무엇을 뜻할까? Reinforcement Learning에서의 모든 판단 기준은 Reward가 된다. 즉 Reward가 높을수록 좋은 것이며, Value Function은 앞으로 받을 Reward에 관한 함수가 되기 때문에 아래와 같이 기댓값 형태로 기술하게 된다.
\[v_\pi(s)=\mathbb{E}_\pi\left[R_{t+1}+\gamma R_{t+2}+\gamma^2 R_{t+3}+\cdots\vert S_t=s\right]\]이 식은 곧 현재 State $S_t=s$가 주어진 상태에서, 그 이후의 Reward들의 총합의 기댓값을 계산하는 함수이다. 그런데 $R_{t+2}$항부터는 $\gamma$가 곱해지는데, 이 $\gamma$를 Discounting Factor라고 부른다. 일종의 감가상각의 개념으로, 현재 State로부터 멀리 떨어져 있을수록 그 중요도가 낮다는 것을 표현하기 위한 값이라고 보면 된다. 그 때문에 $\gamma\in\left[0,1\right]$로 설정한다.
마지막으로 Model 또한 Reinforcement Learning에 선택적으로 등장할 수 있는 요소이다. Model은 Agent 입장에서 Environment가 어떻게 변화할지 예측하는 역할을 한다. 실제로 변화하는 것은 Environment이고, Environment는 어떠한 예측도 없이 그저 정해진 동작에 맞게 변화할 뿐이지만, Agent가 이를 미리 예측할 수 있으면 합리적인 선택을 하기 유리하며 또한 본인이 받을 Reward도 예상할 수 있다.
그래서 Model은 크게 다음의 2가지를 계산한다.
\[\mathcal{P}_{ss^{\prime}}^{a}=\mathbb{P}(S_{t+1}=s^{\prime}\vert S_t=s,A_t=a)\] \[\mathcal{R}_s^a=\mathbb{E}(R_{t+1}\vert S_t=s,A_t=a)\]$\mathcal{P}$는 다음 State를, $\mathcal{R}$은 다음 Reward를 의미한다.
Exploration vs Exploitation
Exploration은 말 그대로 갑자기 여태 안 해본 Action을 시도해보는 것을 의미한다. 아무런 제재가 없다면 Model은 일반적으로 자기가 이미 시도해봐서 검증된 Action만을 반복하게 되며, 이로 인해 “아직 시도하지 않았지만 더 큰 Reward가 있을 수도 있는” 다른 Action을 놓치게 된다. 이 현상을 깨기 위해 Exploration을 넣는다.
Exploitation은 Exploration과 반대 개념이다. 이미 검증된 Action이 명확히 존재하니 이를 반복해서 수행해서 안정적으로 높은 Reward를 받는 것을 의미한다.
이 둘은 서로 Trade-off 관계에 있기 때문에 잘 판단해서 결정해야 한다. 일반적으로 Model이 아직 제대로 훈련되지 않았을 때는 알고 있는 Action이 정말로 최대 Reward를 얻는 Action인지가 불명확하기 때문에 좀 더 다양한 데이터를 모으게 하기 위해 Exploration을 가끔씩 시도하게 한다. 그러나 어느 정도 훈련된 뒤부터는 더 이상 Exploration으로 얻는 이득이 작아지기 떄문에 Exploitation에 비중을 더 두게 된다.