Deep Reinforcement Learning 4 - Model-free Prediction
Before starting
“Class” 카테고리에 있는 포스팅들은 실제로 수업에서 배운 내용을 정리하려는 목적으로 작성되었다. 이 글은 그 중 Deep Reinforcement Learning 과목의 수업을 다룬다.
Model-free Reinforcement Learning
저번 글에서 다룬 Dynamic Programming 적용은 Model-based 상황에서만 가능했다. 그렇다면 Model-free 상황, 즉 Model을 정확히 알지 못하는 상황이라면 어떻게 해야 할까?
우선 Model-free 상황에서도 역시 Prediction 문제와 Control 문제로 나눌 수 있다. 각각 Unknown MDP에서 Value Function을 Estimate하는 방법, 그리고 Value Function 및 Policy를 최적화하는 방법을 다룬다.
이번 글에서는 Prediction 문제만 생각해보기로 하자.
Monte-Carlo Learning
Model을 모르는 상황에서 주어진 Policy를 평가해볼 수 있는 가장 직관적인 방법은 실제로 이 Policy를 따라가며 Episode를 진행하는 것이다. 즉, 주어진 Policy대로 직접 진행하며 그 때 받은 경험들을 토대로 어떤 Reward를 받고 Return이 어떻게 되는지를 살펴보며, 이를 기반으로 이 Policy가 좋았는지를 평가할 수 밖에 없다.
다만 역시 Model을 모르기 때문에 Model-based 상황과 달리 이러한 수행을 여러 번 시뮬레이션하여 데이터를 얻어야 한다. 이것이 Model-free Prediction의 핵심이다.
Monte-Carlo(MC) Learning 역시 이러한 방법을 따른다. MC는 Complete Episode, 즉 Episode가 끝나는 Terminal State가 존재하는 환경에서 사용할 수 있으며, Episode가 끝날 때까지 진행한 후 그 때의 Reward를 계산하고, 이를 바탕으로 Return을 계산한다. 다만 Policy 또한 확률로 정의되기 때문에 이 수행을 한 번만 해서는 제대로 된 평가가 어렵다. 따라서 여러 번 수행 후 그들의 평균값을 계산해야 한다.
Policy Evaluation
우선 간단하게 복습하면, Policy Evaluation의 목적은 주어진 Policy $\pi$에 대해 $V_\pi$를 학습하는 것이다. 이 때 $V(s)=\mathbb{E}\left[G_t\vert S_t=s\right]$, $G_t=r_{t+1}+\gamma r_{t+2}+\gamma^2r_{t+3}+\cdots+\gamma^{T-t-1}r_T$로 정의된다.
이제 MC를 통해 어떻게 Policy를 평가할 수 있을지 알아보자. Monte-Carlo Policy Evaluation은 Expected Return 대신 Empirical Mean Return을 사용한다. 이 기댓값을 계산하려면 각 State $s$에 대해, 방문 횟수와 Return의 총합을 기록하면 된다.
즉 Episode가 끝날 때마다 각각의 State $S_t$와 그 때의 Return $G_t$에 대해 다음과 같이 $V(s)$를 업데이트한다.
\[N(S_t)\leftarrow N(S_t)+1\] \[V(S_t)\leftarrow V(S_t)+\dfrac{1}{N(S_t)}(G_t-V(S_t))\]여기서, 원래 $V(S_t)$는 $Z(S)\leftarrow Z(S)+G_t$, $V(S)=Z(S)/N(S)$로 계산되는데, 이런 식의 Incremental Mean은 다음과 같이 변형이 가능하다.
\[\begin{aligned} u_k&=\dfrac{1}{k}\sum_{j=1}^kx_j \\ &=\dfrac{1}{k}\left(x_k+\sum_{j=1}^{k-1}x_j\right) \\ &=\dfrac{1}{k}(x_k+(k-1)u_{k-1}) \\ &=u_{k-1}+\dfrac{1}{k}(x_k-u_{k-1}) \end{aligned}\]그래서 위의 $V(S_t)$가 저런 식으로 계산된다. 이 편이 $N$을 업데이트하듯이 현재 값을 빠르게 업데이트할 수 있어 효율적이기도 하고, 만일 Non-stationary MDP라서 환경이 계속 변화한다면 이전 Episode에서의 값을 조금 덜 반영되게 하기 위해 아래와 같이 가중치 $\alpha$를 걸어주기에도 용이하다.
\[V(S_t)\leftarrow V(S_t)+\alpha(G_t-V(S_t))\]이 $\alpha$는 Supervised Learning에서의 Learning Rate와 비슷한 개념이라고 생각할 수 있다.
또한 동일 State의 재방문을 어떻게 처리하느냐에 따라 First-visit MC와 Every-visit MC로 나뉜다. 이름 그대로, 전자는 State를 처음 방문했을 때에만 체크하고, 후자는 State를 방문할 때마다 체크한다. 다만 $n\rightarrow\infty$라면, 이 둘은 결국 같은 값으로 수렴한다고 한다.
이 시도횟수 $k$가 늘어날수록 점점 더 정확한 $V(s)$를 얻을 수 있다. 즉 $N(s)\rightarrow\infty$라면, $V(s)\rightarrow V_\pi(s)$가 된다.
Temporal-Difference Learning
Monte-Carlo Learning은 Episode가 끝나야만 계산이 가능하다. 그런데 Model-free 상황에서 Episode가 끝나지 않는 문제거나 혹은 끝나기 전에라도 계산을 하고 싶다면 어떻게 해야 할까? 이럴 때 사용하는 방법이 Temporal-Difference(TD) Learning이다. 하나의 Episode가 완벽히 끝나지 않은 상황이기 때문에 Guess를 업데이트하는 식으로 동작하게 된다.
Monte-Carlo Learning과 비교해보자. MC에서는 Episode가 끝나는 상황을 다루기 때문에 실제 Return $G_t$를 계산할 수 있다. 그래서 $G_t$를 이용한 Value Function $V(S_t)$의 업데이트가 가능하다.
\[V(S_t)\leftarrow V(S_t)+\alpha(G_t-V(S_t))\]Temporal-Difference Learning에서는 이 실제 Return $G_t$를 얻을 수 없기 때문에, 다음과 같이 Estimated Return인 $r_{t+1}+\gamma V(S_{t+1})$을 이용한다.
\[V(S_t)\leftarrow V(S_t)+\alpha(r_{t+1}+\gamma V(S_{t+1})-V(S_t))\]이 값은 어디까지나 “Estimated” Return이기 때문에, 이를 Guess를 업데이트한다고 표현한다. 또한 이 때 예측한 Return인 $r_{t+1}+\gamma V(S_{t+1})$을 TD Target이라고 부르고, 이 Estimated Return과 현재 State의 Value와의 차이를 TD Error $\delta_t$라고 부른다. 즉,
\[\delta_t=r_{t+1}+\gamma V(S_{t+1})-V(S_t)\]Bias-Variance Trade-off
이제 MC와 TD를 비교해보자. MC는 실제 Return $G_t$를 이용하기 때문에 반드시 Episode가 끝나야만 계산이 가능하다. 이 때문에 Complete Sequence로부터만 학습이 가능하며, Terminal State가 존재하는 환경에서만 동작한다. TD는 이와는 다르게 Estimated Return을 쓰기 때문에 Episode가 끝나지 않아도 학습이 가능하다. (이를 “Online”이라고도 표현한다.) 그리고 이로 인해 Incomplete Sequence나 Non-terminating Environment에서도 학습이 가능하다.
MC와 TD는 이러한 차이점 외에도 Bias와 Variance의 관점에서도 비교해볼 수 있다.
MC는 실제 Return $G_t$를 이용하기 때문에 이 값은 시행 횟수만 많다면 결국 $V_\pi(S_t)$에 수렴하는, Zero bias 방식이다. 이 덕분에 잘 수렴하고, 초기 값에 그렇게 큰 영향을 받지 않는다. 대신 Episode 전체를 봐야 하기 때문에 Episode가 길수록 그 안에서 일어날 수 있는 다양한 Action 및 Transition에 따라 Return이 크게 달라지게 된다. 즉 Variance가 크다.
TD는 반대로 실제 Return이 아닌 Estimated Return을 이용하기 때문에 정확히 특정한 점에 수렴한다고 보긴 어렵다. 즉 MC에 비해 어느 정도의 Bias가 존재할 수 밖에 없으며 이로 인해 초기값에 영향을 받는 편이다. 하지만 오로지 다음 State의 예측값만 가지고 계산하기 때문에 전체 Episode를 모두 보는 MC와 달리 TD Target이 그리 크게 변동되지 않는다. 즉 Variance가 낮다.
Unified View
이상의 내용을 종합하면 다음과 같은 사진으로 표현할 수 있다.
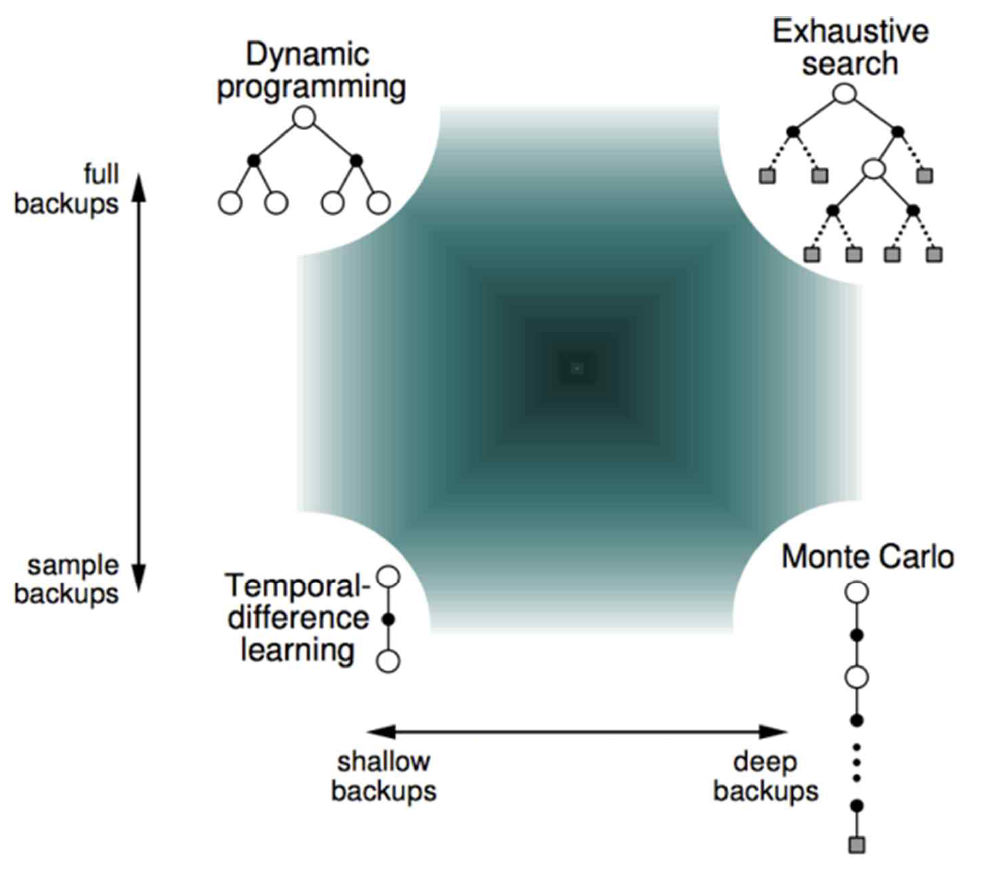
Model을 알고 있는 상황이라면 “모든” 경우를 다 확인할 수 있다. 이걸 Full backup이라고 부르며, 이와 반대되는 상황은 Model을 모르기 때문에 모든 상황을 알지 못하고, 따라서 일부 상황을 Sampling해서 확인한다. 이를 Sample backup이라고 부른다.
또한 한 Episode를 Backup할 때 끝까지 내려가서 Deep Backup하느냐 혹은 일부만 확인하는 Shallow Backup을 하느냐에 따라서도 구분할 수 있다.
이러한 관점에서, 여태까지 배운 3가지의 방법 (DP, MC, TD)는 다음과 같이 구분이 가능하다.
- DP는 Model을 알고 있어 모든 상황을 알고 있으며, 점화식을 통해 다음 단계만 Backup한다. 즉, Full + Shallow Backup이다.
- MC는 Model을 모르기 때문에 Sampling을 통해 Episode를 확인해야 하며, 이렇게 뽑힌 Episode의 실제 Return을 계산하므로 이 트리의 끝까지 확인한다. 즉 Sample + Deep Backup이다.
- TD도 Model을 모르기 때문에 Sampling을 해야 하며, 각 Episode의 Estimated Return을 계산하므로 트리도 얕게 확인한다. 즉 Sample + Shallow Backup이다.