Text Mining 3 - Dense Contextual Representation
Before starting
“Class” 카테고리에 있는 포스팅들은 실제로 수업에서 배운 내용을 정리하려는 목적으로 작성되었다. 이 글은 그 중 Text Mining 과목의 수업을 다룬다.
Contextual Representation
저번 글에서 다뤘던 Dense Static Representation은 단어별로 고정된 vector를 갖는다. 즉, 해당 단어가 문장 내에서 어떤 의미로 사용되었는지를 고려하지 못한다. 예를 들어, “bank”라는 단어는 문맥에 따라 “은행” 혹은 “강둑”이라는 의미로 사용될 수 있으나 이렇게 다른 의미로 사용되더라도 전부 같은 vector로 변환되는 것이다.
Dense Contextual Representation은 이러한 문제를 해결하기 위해, 각 단어가 문맥에 따라 다른 vector로 변환되도록 하는 방법이다. 이를 만들기 위해 ELMo(Embeddings from Language Model)를 비롯한 RNN 계열의 모델 등 다양한 시도들이 있었지만, 현재까지 살아남은 것은 결국 Self-Attention 계열의 방법이다.
참고로 딥러닝 관점에서의 Self-Attention 및 Transformer 및 관련 모델들은 이미 다른 글에서 다뤘기 때문에, 여기선 Text Mining 관점, 즉 Encoding 관점 위주로 다룰 예정이다.
Self-Attention
결국 우리의 목적은 특정 단어를 나타낼 때 그 맥락을 잘 반영하고자 하는 것이다. 이를 위해선 결국 Target word 주변의 Context word를 잘 파악해야 한다. 그런데 모든 Context word가 똑같이 중요한 것은 아니다. 동일한 “bank”라는 단어라도 근처에 “river” 같은 단어가 나오면 이는 “강둑”이라는 의미로 사용되었다는 의미이고, 근처에 “cash”나 “withdraw” 같은 단어가 나오면 이는 “은행”이라는 단어로 사용되었다는 의미이다. 즉, Context word 중 “더 중요한 단어”를 파악하고 그것을 반영하기 위한 작업이 필요하고, Attention 역시 그러한 개념에서 등장했다.
기본적인 아이디어는 Dense Static Representation으로 변환된 vector에서부터 출발해서, 각 vector에 대해 가중치를 부여하는 것이다.
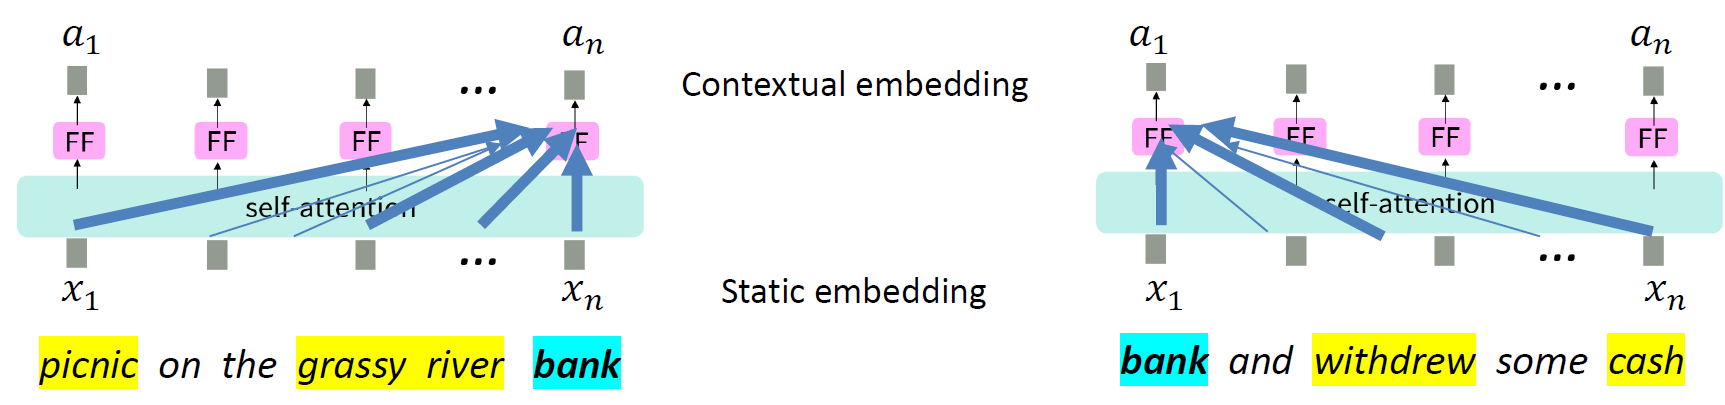
위와 같이 동일한 단어라도 문맥에 따라 주변 vector들이 다르기 때문에, 이를 통해 서로 다른 가중치가 부여되어 같은 단어라도 최종적인 vector는 다르게 된다.
\[a_i=\sum_{x_j\in x}\alpha_{ij}x_j,\quad\sum_{x_j\in x}\alpha_{ij}=1\]수학적으로도 그저 총합이 1인 가중치를 계산하여, 그를 이용한 가중합을 계산하는 것에 불과하다. 이 가중치 $\alpha_{ij}$는 Attention score라고 불리며, 다음과 같이 softmax를 이용하여 계산한다.
\[\alpha_{ij}=\text{softmax}(x_i\cdot x_j)=\dfrac{\exp(x_i\cdot x_j)}{\sum_{j^{\prime}}\exp(x_i\cdot x_{j^\prime})}\]여기서도 역시 두 vector 간의 유사도가 중요한 것이기에 두 vector에 대한 inner product를 사용한다.
이러한 구조를 통해 기본적인 Self-Attention을 구현할 수 있는데, 다만 한 가지 문제가 있다. 위의 구조는 기본적으로 자기 자신 또한 계산에 포함된다. 아무래도 각 단어별로 가장 많이 붙어나오고, 또 가장 중요한 단어는 당연히 자기 자신일 수 밖에 없기 때문이다. 즉, 자기 자신에 대한 inner product가 압도적으로 커져서 문맥에서의 중요도를 적절히 반영하지 못한다는 문제가 생긴다.
따라서 이 문제를 해결하기 위해 다음과 같이 Query, Key, Value라는 개념을 도입한다.
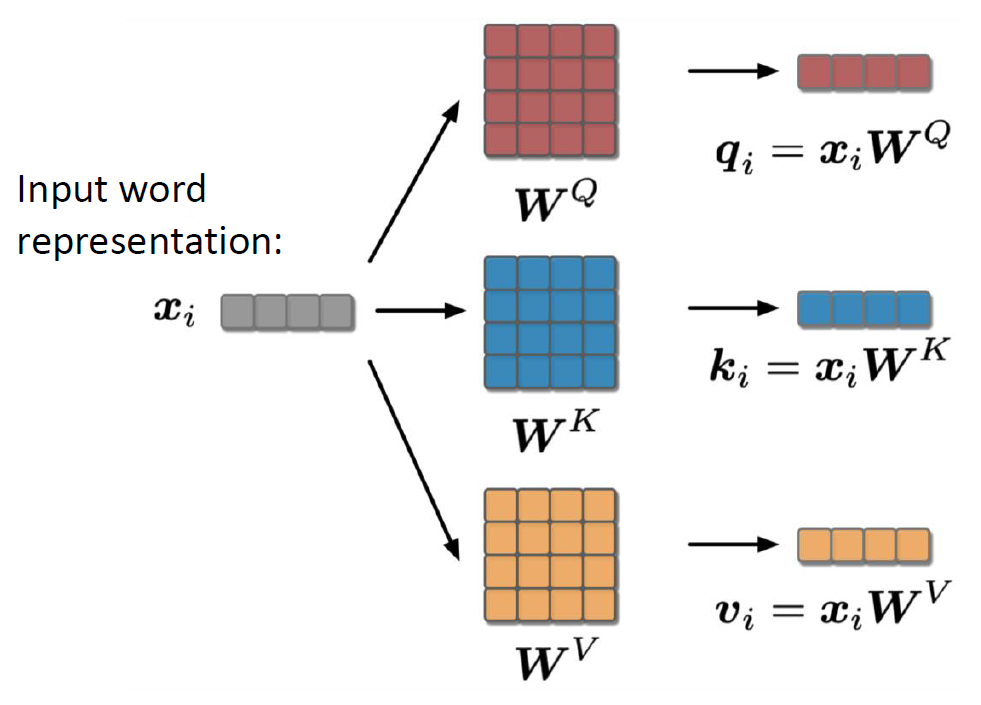
위 그림과 같이, 하나의 input word vector $x_i$에 대해, 특정한 matrix $W^Q$, $W^K$, $W^V$를 곱하여 이 vector에 대한 Query, Key, Value로써의 특징이 잘 드러나도록 가공하는 개념이다.
Query는 특정한 target word를 이해하려는 입장에서 질문을 하는 제시어의 역할(“지금 어떤 단어를 더 중요하게 봐야 하는가?”)을 하고, Key는 그에 대해 대답하는 역할이다. Value는 이렇게 얻어진 정보를 전달하는 역할을 담당한다.
그러면 이 Query, Key, Value 개념을 반영한 전체적인 Self-Attention은 다음과 같이 계산된다.
우선 각각의 vector $x_i$에 대해 Query $Q$, Key $K$, Value $V$를 계산한다.
\[q_i=x_iW^Q,\quad k_i=x_iW^K,\quad v_i=x_iW^V\]그리고 Attention score를 계산하는데, 다음과 같이 $q_i$와 $k_j$에 대한 inner product로 계산한다.
\[\alpha_{ij}=\text{softmax}(q_i\cdot k_j)=\dfrac{\exp(q_i\cdot k_j)}{\sum_{j^{\prime}}\exp(q_i\cdot k_{j^{\prime}})}\]이는 가중치 $\alpha_{ij}$는 $i$의 입장에서 $j$가 얼마나 중요한지를 나타내는 값이기 때문이다. 그 후 실질적인 vector는 다음과 같이 $v_i$를 사용한다.
\[a_i=\sum_j\alpha_{ij}v_j\]그런데 위의 과정은 결국 특정 context 하나에 대해 반영하는 셈이다. 그러나 이를 한 번만 수행하게 되면 그 문맥에 내재된 단어 간의 관계를 얕게만 학습하게 된다. 예를 들어서 “bank”와 “picnic”은 직접적인 관계가 옅은 단어들이다. “bank”와 “river”가 연관되어 있고, “river”와 “picnic”이 연관되어 있어서 결과적으로 “bank”와 “picnic”이 관계가 있음을 알아야 하는데, 이러한 과정은 한 번의 Attention 계산으로는 힘들다.
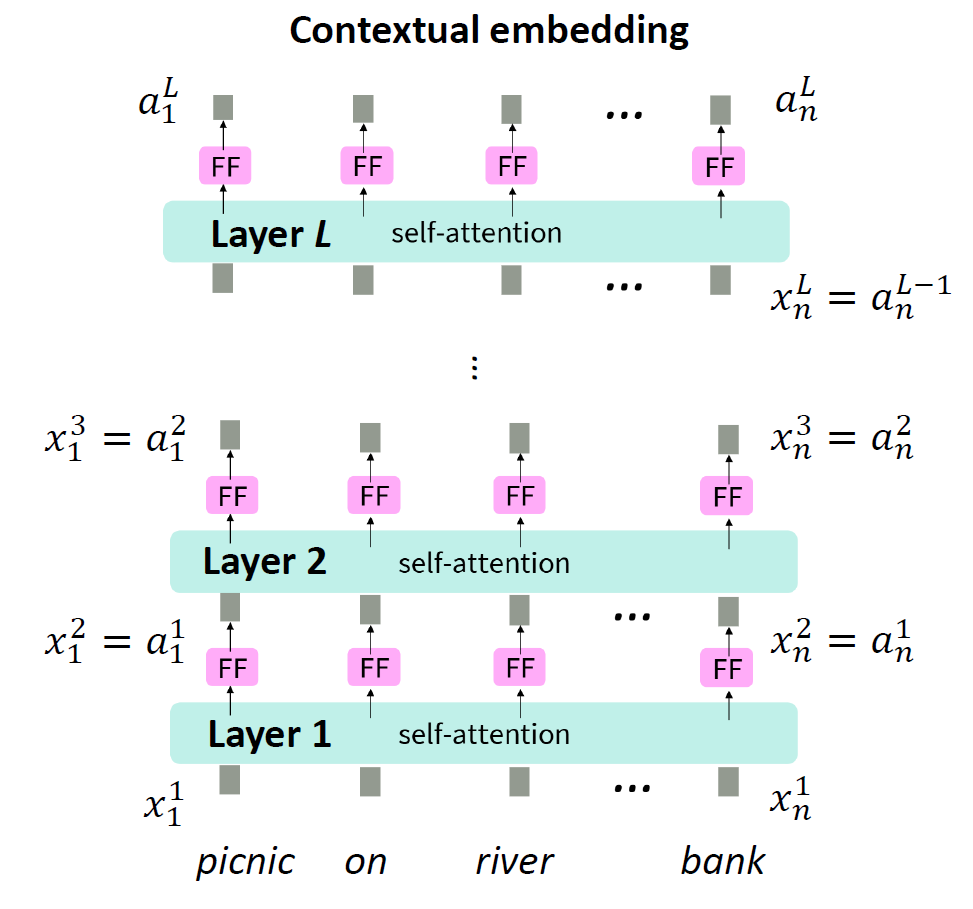
그래서 이렇게 Attention Layer를 여러 개 쌓아, 좀 더 간접적인 관계까지 제대로 전파되도록 한다.
BERT
그렇다면 각각의 matrix $W^Q$, $W^K$, $W^V$는 어떻게 구할 수 있을까? 이 값은 결국 계산하는 것으로는 부족하고, 학습을 통해 구해야 한다. 즉 Self-Attention 자체는 단순한 계산이지만, 여기에 사용되는 값들을 구해서 실제로 활용하려면 결국 모델을 구성해 학습해야 한다.
이러한 용도로 만들어진 모델들 중 널리 알려진 것 중 하나가 바로 BERT(Bidirectional Encoder Representations from Transformers)이다.
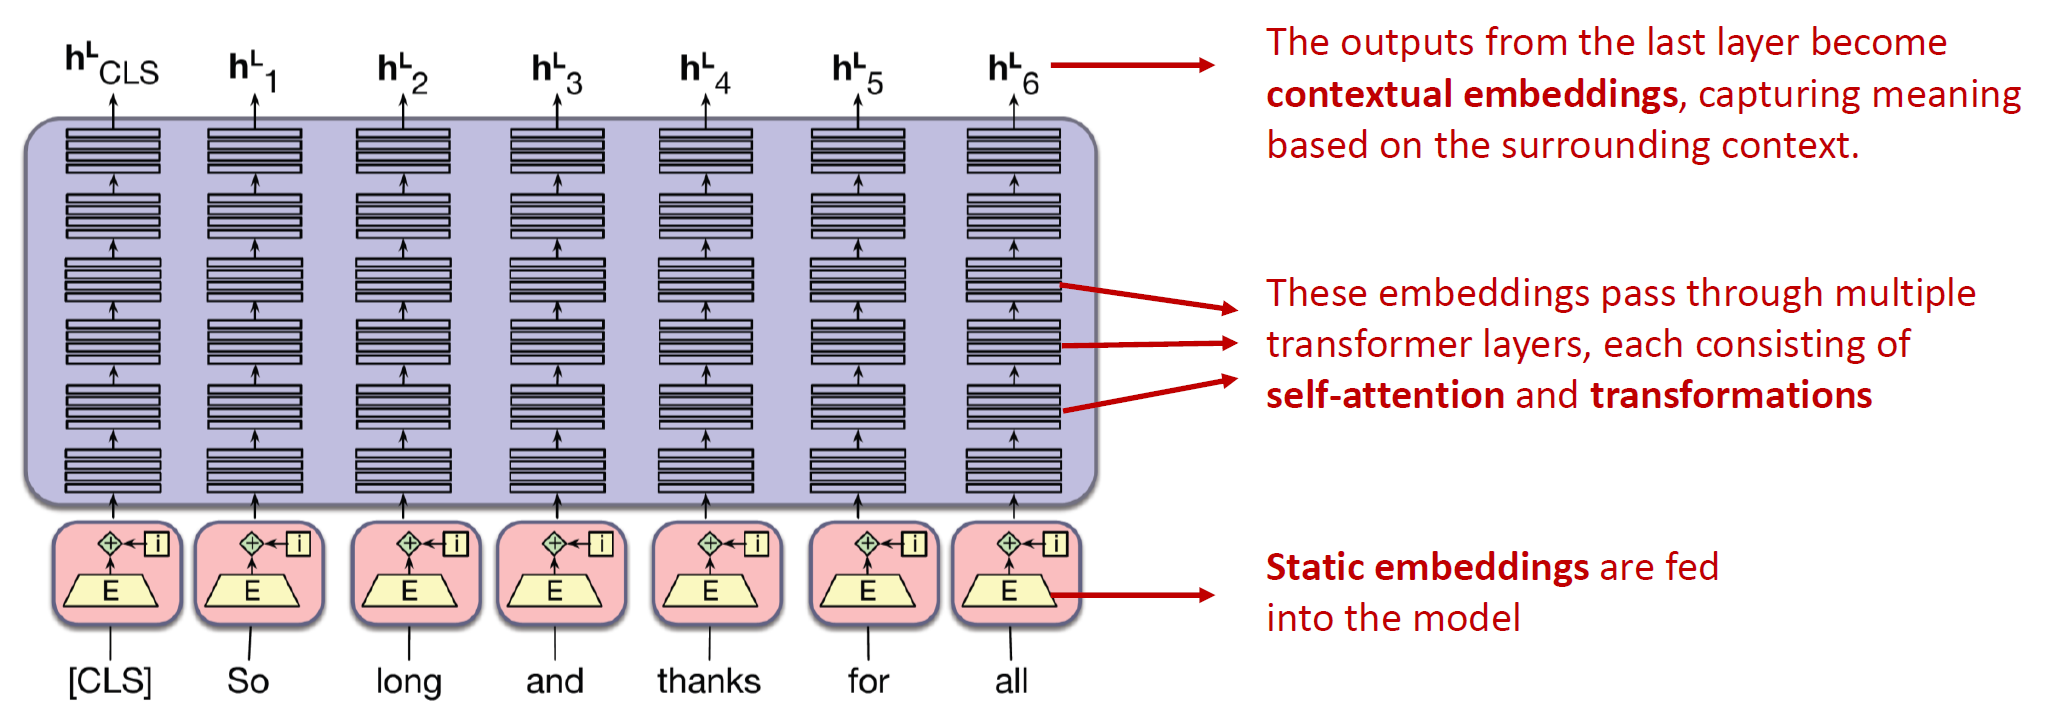
BERT의 전체적인 구조는 위 사진과 같다.
먼저 Input부터 확인해보자. 각 word들은 vector로 변환되어야 하는데, 이를 위해 이들을 각각 Token으로 변환한다. 이러한 과정을 Tokenization이라고 부른다. 각각의 token들은 하나의 scalar로 구성되는데, 이 값은 해당 위치만 1인 one-hot vector로 취급된다. 이렇게 구성된 one-hot vector를 따로 갖고 있는 Embedding table과 곱해 Static Representation vector를 얻는다.
여기서 이 Static Embedding은 저번 글에서 다뤘던 Word2Vec을 그대로 쓸 수도 있고, 혹은 이것조차도 랜덤하게 초기화하고 처음부터 학습시킬 수 있다. 선택의 문제이나 BERT에서는 후자의 방법을 택했다.
그 후에는 앞서 보았던 Attention Layer를 여러 개 쌓는 식으로 모델을 구성한다. BERT에서는 이를 12 혹은 24번 중첩시켰다. 그렇게 해서 얻은 이 모델의 output은 $h_n^L$로 표현되는 Contextual Embedding이 된다.
Optimization
그러면 어떻게 BERT를 학습시킬 수 있을까? BERT는 크게 두 가지 방법으로 학습되었다.
첫 번째 방법은 Masked Language Modeling(MLM)이다. 이는 문장 내에서 일부의 단어들을 랜덤하게 masking한 후, 그 masking된 단어를 맞추는 식으로 학습시키는 방법이다.
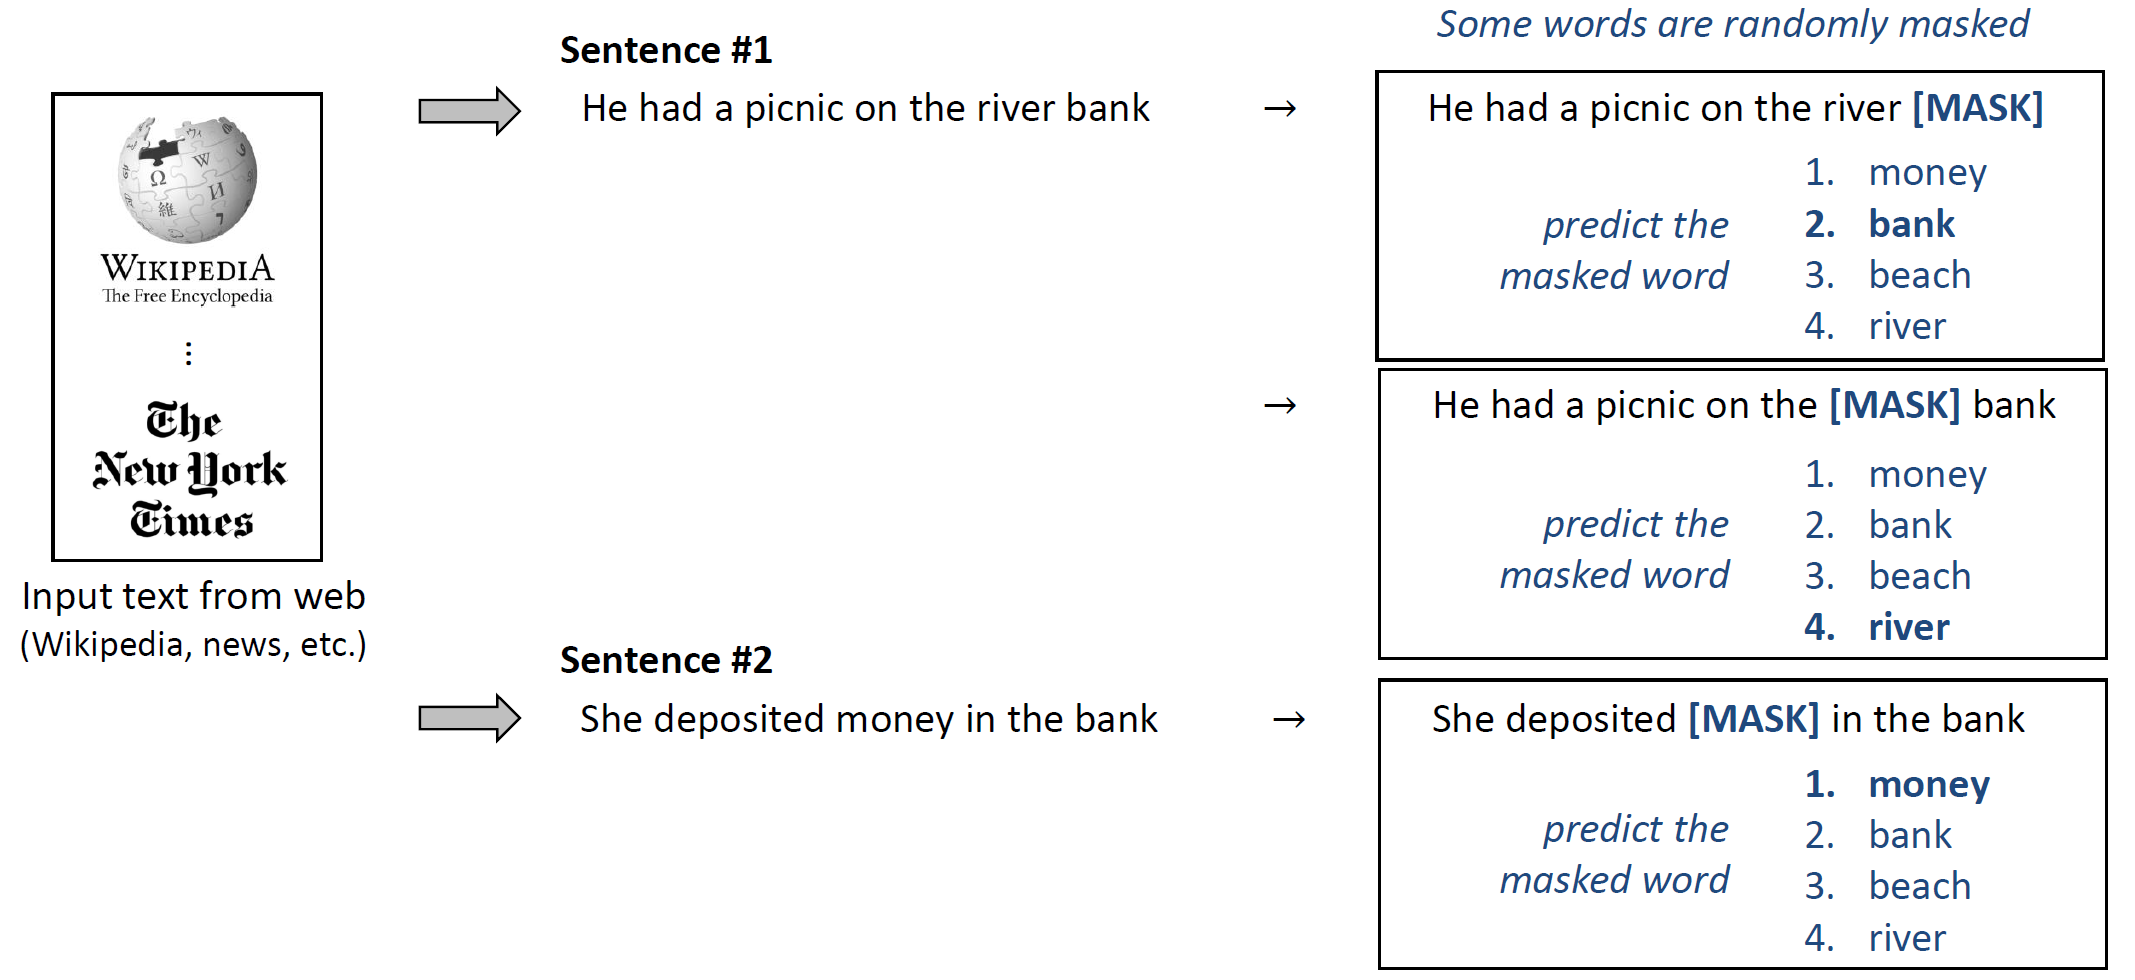
당연히 문장별로 masking의 위치가 정해진 것은 아니고, 약 15%의 비율을 유지하면서 랜덤하게 변경된다. 이러한 task를 각종 매체에서 얻을 수 있는 방대한 텍스트 데이터에 대해 다 수행하는 것이다.
MLM이 왜 Self-Attention에 효과적일까? Self-Attention의 핵심은 결국 input이 들어왔을 때 그 input 중 지금 target word와 관련된 제일 중요한 정보가 무엇인지를 스스로 식별하는 능력이다. 즉, 다른 단어들과의 가중치를 계산할 수 있어야 하고, MLM은 이를 가장 직접적으로 훈련시키는 방법이 된다. 빈 단어를 맞추기 위해선 주변의 단어들을 끌어모아 context를 유추해야 하고, 이를 유추하기 위해선 결국 가장 중요한 정보가 무엇인지 알아야만 하기 때문이다.
그럼 이제 실제로 MLM을 통해 학습시키는 방법을 알아보자. $M$을 Masked position의 집합이라고 하면, 이 task에서의 loss는 다음과 같다.
\[L_{MLM}=-\dfrac{1}{\vert M\vert}\sum_{i\in M}\log P(x_i\vert h_i^L)\]Self-Attention Layer의 결과물로 얻어지는 $h_i^L$을 input으로 사용한다. 이를 통해 가려진 원문 $x_i$를 얻을 확률 $P(x_i\vert h_i^L)$을 최대화하는 것이 목표가 된다.
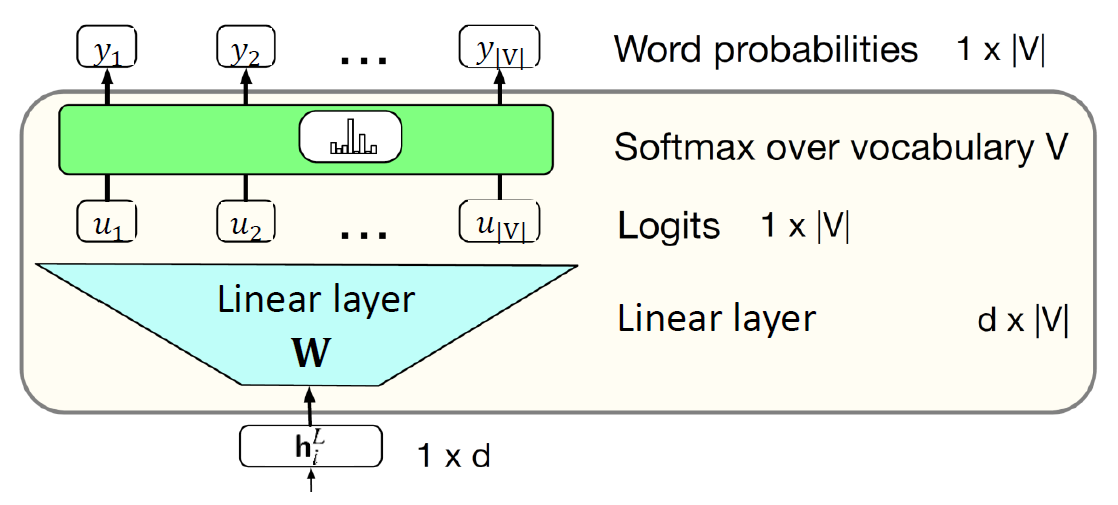
따라서 이 Task를 수행할 모델은 위 사진과 같이 BERT 위에 추가적인 Linear Layer를 붙이고 softmax를 통해 각 단어의 분포를 계산하는 형태가 된다.
즉, 실제 단어 $i$가 등장할 확률 $y_i$는 $\text{softmax}(h_i^LW)$로 계산된다.
여기서 $W$는 Static embedding vector와 vocabulary 간의 관계가 기술된 matrix이다. 이 matrix 또한 따로 학습시켜도 되지만, 잘 생각해보면 이 matrix는 결국 앞서 BERT의 tokenizing 과정에 사용한 Embedding table $E$의 Transpose와 동일한 역할을 하고, 그 크기조차도 일치함을 알 수 있다. 따라서 $W=E^T$로 두는 weight-tying을 통해 학습해야 할 파라미터의 수를 줄인다.
두 번째 방법은 Next Sentence Prediction(NSP)이다. 이는 두 문장 $A$와 $B$가 주어졌을 때, $B$가 $A$의 다음 문장인지 아닌지를 맞추는 식으로 학습시키는 방법이다.
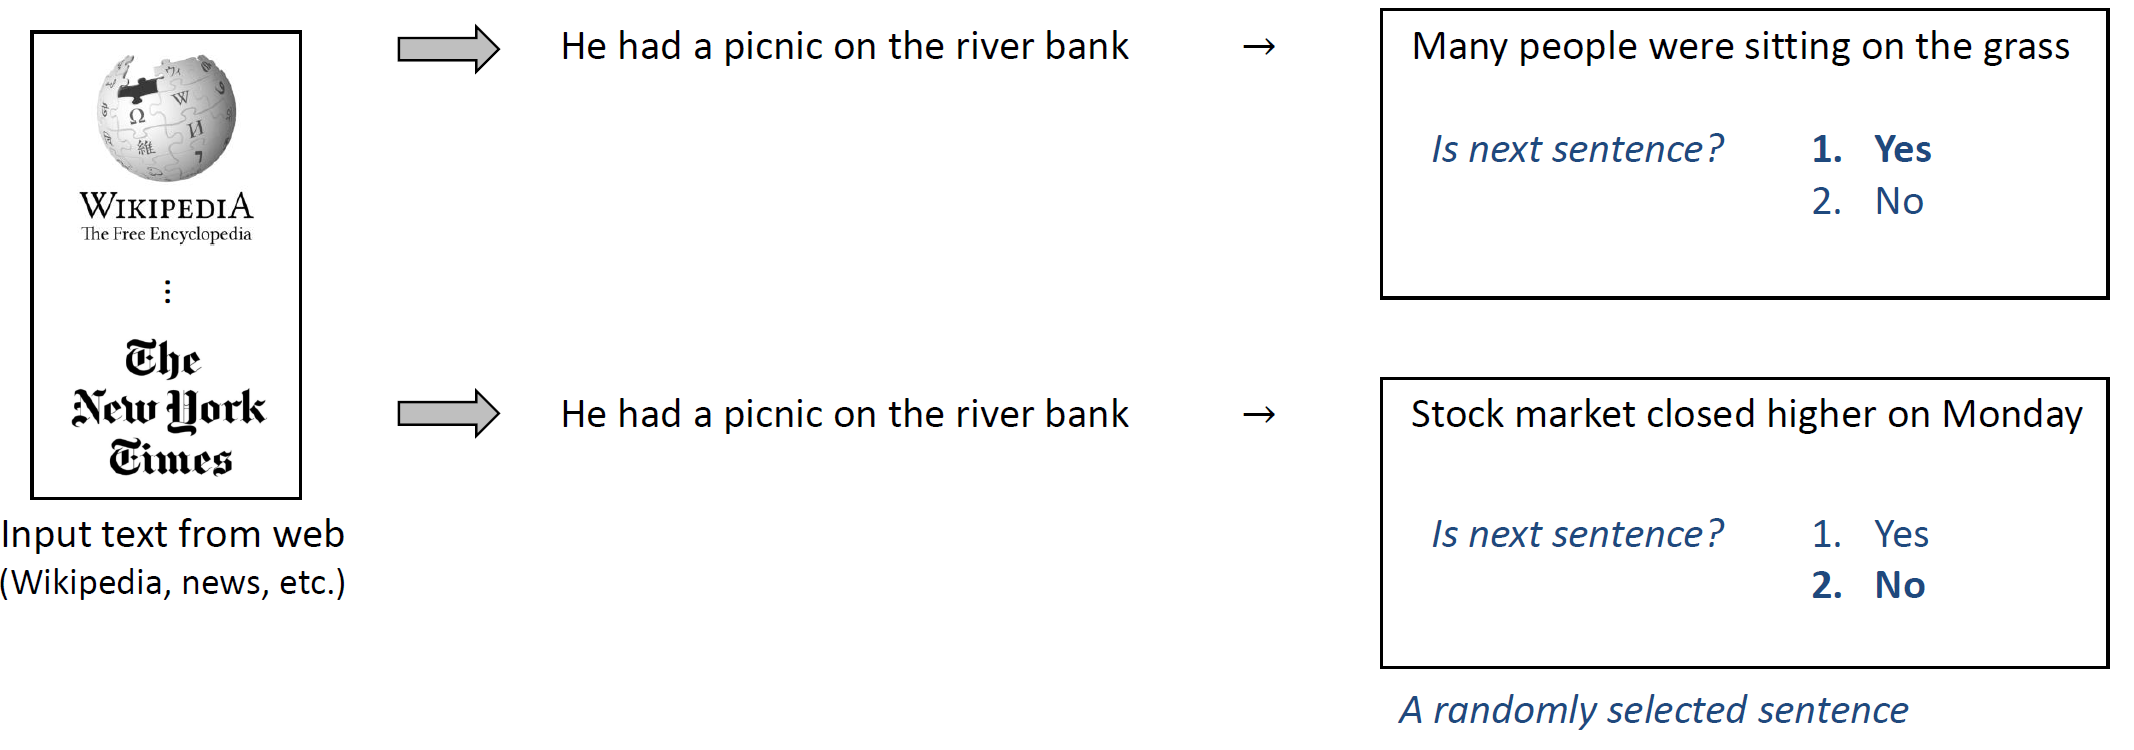
이 경우 문장을 총합해서 요약할 정보를 담을 [CLS] token과 문장을 구분하기 위해 두 문장 사이에 [SEP] 라는 특수한 token을 추가로 넣어주게 된다. BERT의 output 중 [CLS] token만 확인하여 이 모델이 제대로 정답을 냈는지를 확인하면 된다.
NSP의 본래 의도는 문장 내의 관계만 확인하는 MLM과 달리 문장 간의 일관성 및 문장을 가로지르는 문맥이나 논리 등을 학습하는 것이었다. 하지만 실제론 이 의도와는 다르게 NSP 자체는 BERT 학습에 그다지 큰 도움은 되지 못했음이 밝혀졌다. 그래도 이 아이디어 및 디자인 자체는 NLP의 여러 task에 영향을 미쳤다고 한다.
이제 실제로 NSP를 통해 학습시키는 방법을 알아보자. 앞서 언급했듯, 두 문장이 동시에 들어오고 그 결과를 [CLS] token을 통해 확인한다. 즉, NSP task에서의 loss는 다음과 같이 계산된다.
여기서 $y$는 두 문장이 이어지는지 여부만 판단하는 binary label이고, $y=\text{softmax}(h_{CLS}^LW_{NSP})$로 계산된다.
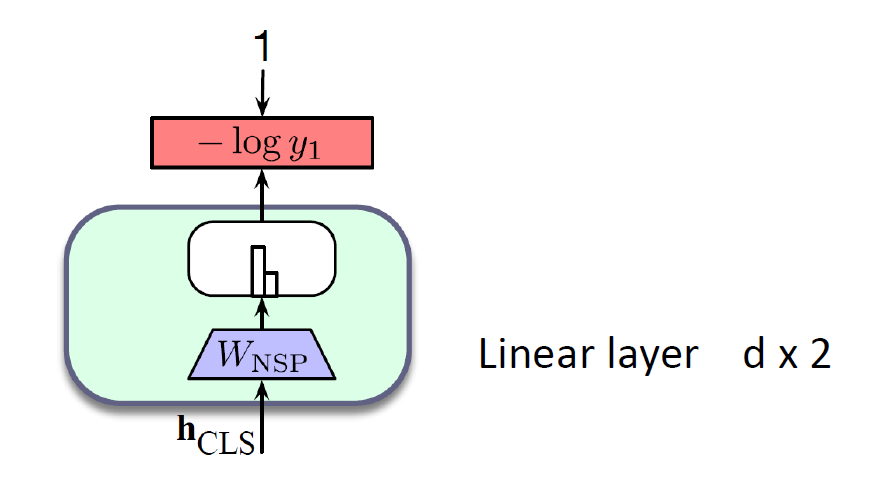
MLM에 비해 간단한 Task인만큼 이를 수행할 모델 역시 위 사진과 같이 간단하다.
BERT는 이들 두 Task를 동시에 적용해서 학습되었다. 즉, 최종적인 Loss $L_{BERT}=L_{MLM}+L_{NSP}$로 두고 이를 최적화시켰다.
Word sense disambiguation
이렇게 얻은 Embedding vector를 확인해보면 같은 단어가 여러 곳에 생긴 것을 확인할 수 있다.
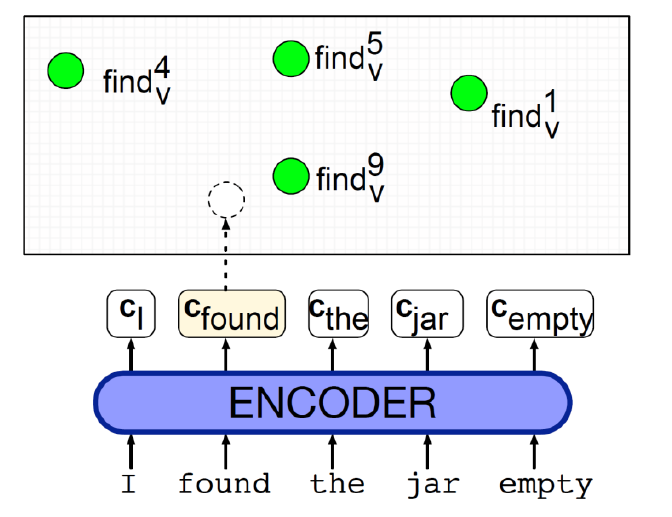
위 사진과 같이 동일한 단어 “find”여도 이 단어가 갖고 있는 의미에 따라 Embedding Space 내에서 여러 곳에 위치하게 되고, 각 문장에서 유도된 “find”의 vector를 확인하여 가장 근접한 곳에 있는 “find”의 vector를 찾는 식으로 해당 단어의 의미를 특정할 수 있다.