Text Mining 2 - Dense Static Representation
Before starting
“Class” 카테고리에 있는 포스팅들은 실제로 수업에서 배운 내용을 정리하려는 목적으로 작성되었다. 이 글은 그 중 Text Mining 과목의 수업을 다룬다.
Dense Representation
저번 글에서 다뤘던 Sparse Representation은 vector의 크기가 상당히 크다. Vector의 dimension이 정확히 Vocabulary의 개수와 같고 대부분이 0이기 때문에 그리 효율적이지 않은 방법이다. Dense Representation은 이러한 문제를 개선해서, 상대적으로 훨씬 짧은 길이의 Vector로 매핑하는 방법을 다룬다.
이러한 Dense Representation은 다시 2개의 방법으로 나눌 수 있다. 첫 번째는 한 단어는 항상 고정된 Vector를 갖는 Static Embedding이고, 두 번째는 문맥에 따라서 단어의 Vector가 달라지는 Contextual Embedding이다. 이 글에서는 그 중 Dense Static Representation을 다룬다.
Word Embeddings
Sparse Representation에서는 Document와 Term 간의 관계를 이용해서 Vector로 표현했었다. Dense Static Representation에서는 그 대신 각 Word를 일단 Vector로 나타내고, 이 단어들을 종합해서 Document를 Vector로 표현하는 방법을 사용한다.
즉, 각 Word를 Vector로 표현하는 방법이 먼저 필요하다. 이를 위해 언어학에서 유래된 아이디어인 Distributional Hypothesis를 활용한다. Distributional Hypothesis는 “어떠한 단어들이 유사한 맥락에서 나온다면, 이 단어는 유사한 의미를 가질 것이다”라는 가정으로, 이 가정을 기반으로 해서 의미적으로 유사한 단어들, 즉 비슷한 맥락에서 등장하는 단어들은 유사한 벡터를 가지게 한다.
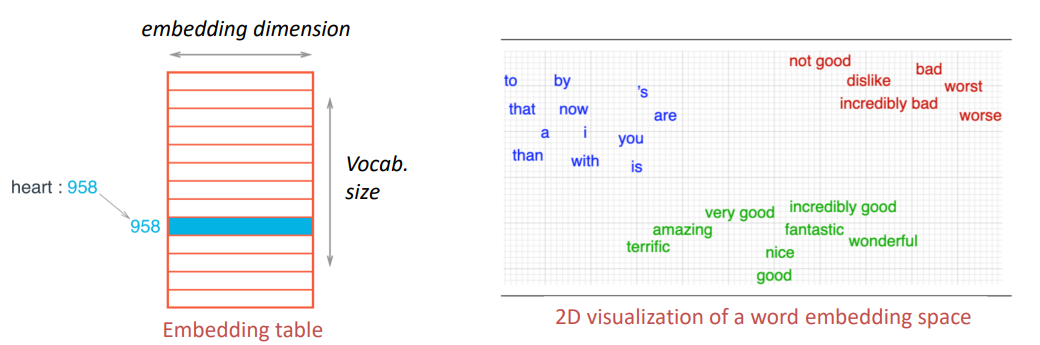
그리고 Word Embedding은 이러한 가정 아래에서 각 Word와 Vector를 매핑해주는 함수가 되며, 이를 손쉽게 Visualize할 수도 있다.
Word-context Information
그러면 이러한 Word Embedding, 혹은 Embedding Table은 어떻게 얻을 수 있을까? 그 시작은 각 Word에 대한 Context information을 구축하는 것이다. 여기에 사용할 수 있는 방법이 저번 글에서 다뤘던 Word-word co-occurrence matrix이다.
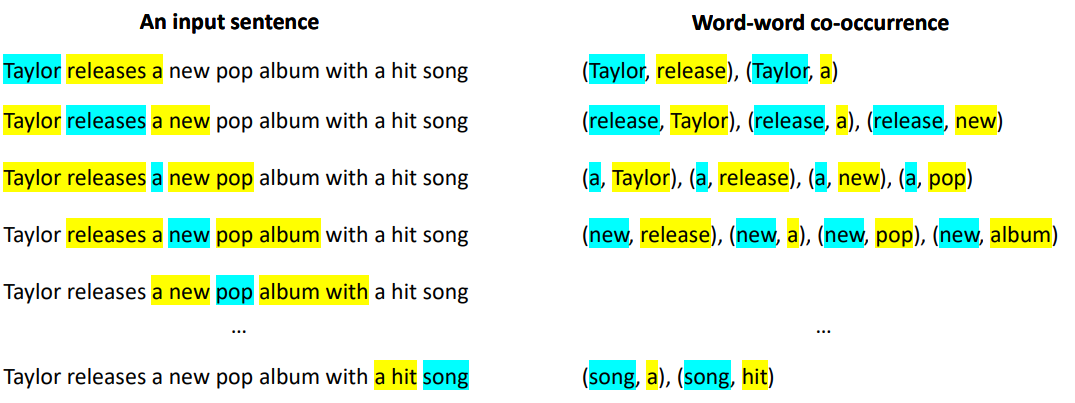
Word-word co-occurrence matrix를 구성하기 위해서 먼저 위 사진과 같이 정해진 Size만큼의 Sliding Window를 각 문장에 적용해서, 어떠한 단어들이 서로 인접해있는지를 파악한다. 이 때 중심이 되는 단어를 Target word, 그 주변의 단어들을 Context word라고 부른다.
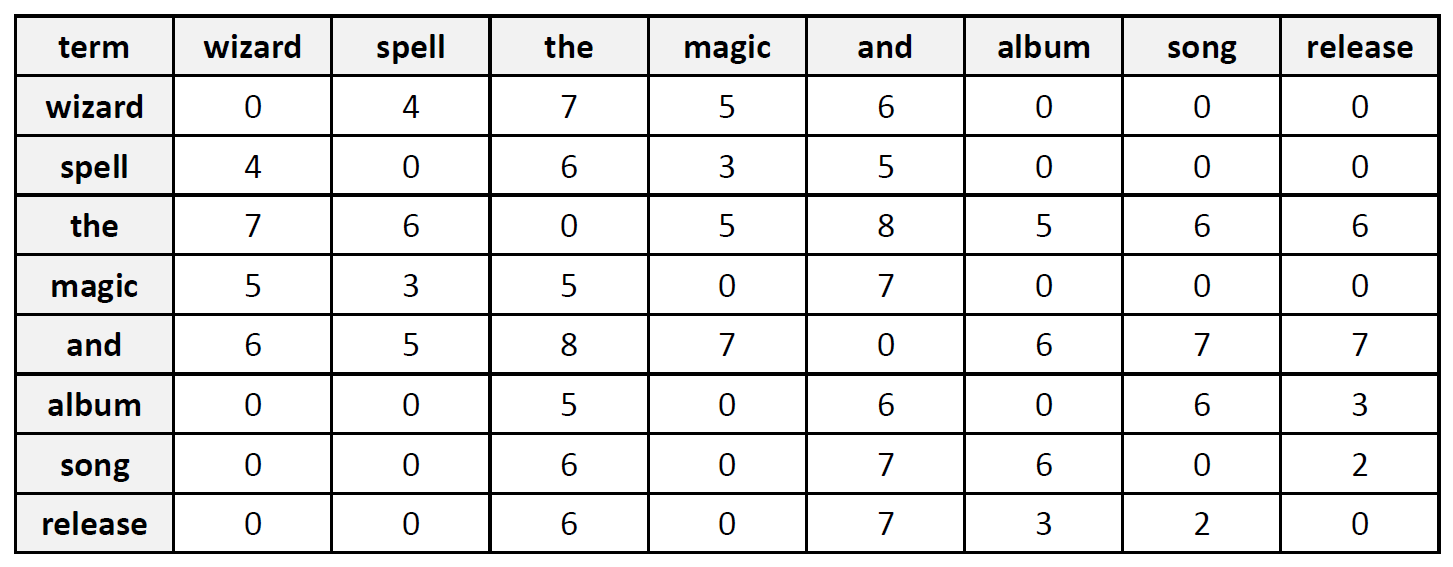
이 정보들을 모아서 위와 같은 Matrix를 만들 수 있는데, 이것이 바로 Word-word co-occurrence matrix이다. 이 Matrix의 각 row와 Column은 등장하는 모든 Vocabulary를, 각 element는 이들 두 단어의 쌍이 총 몇 번 등장했는지를 의미한다.
이렇게 정리한 matrix의 특정 row를 확인해보면, 이 벡터는 곧 Distributional Hypothesis를 그대로 반영하고 있음을 알 수 있다. 즉, 이 vector는 전체적인 등장 숫자를 그대로 세서 표현했기 때문에 비슷한 맥락에서 등장하는 단어들은 비슷한 vector를 가지게 된다.
다만 이 vector는 여전히 Sparse하다. 따라서 이 vector의 의미를 살리면서 Dense하게 만들어야 한다. 즉, Sparse한 Word-word co-occurrence를 Input으로 받아, Dense Representation을 Output으로 낼 방법이 필요하다. 이를 위해선 크게 다음의 2가지 방법이 존재한다.
1. Dimensionality reduction
첫번째 방법은 Dimensionality reduction, 즉 차원 축소이다. 결국 위의 문제를 해결하는 가장 직관적인 방법에 해당한다. 다만 실제로 차원 축소를 적용하기 전에 Re-weighting 과정을 거쳐야 한다. 이는 저번 글에서 다뤘듯이 빈도수만 세는 방식은 그다지 좋은 의미를 전달하지 못하기 때문이다.
이 Re-weighting 과정으로 널리 사용되는 방법이 PMI (Pointwise Mutual Information) re-weighting이다. 단어 $w_1$, $w_2$에 대한 PMI는 다음과 같이 정의된다.
\[\text{PMI}(w_1, w_2)=\log\dfrac{P(w_1,w_2)}{P(w_1)P(w_2)}\]여기서 $P(w)$는 단어 $w$가 등장할 확률, 즉 $\dfrac{\text{count}(w)}{N}$을 의미한다. $N$은 전체 Pair의 수이다. 그리고 $P(w_1, w_2)$는 $w_1$과 $w_2$가 동시에 등장할 확률을 의미한다. 이 PMI는 두 단어가 우연히 같이 나오는 것에 비해 얼마나 더 유의미하게 자주 등장하는지를 나타낸다.
이렇게 Input matrix를 PMI re-weighting을 통해 재구성 한 뒤, 차원 축소를 적용하면 Dense Representation을 얻을 수 있다. 차원 축소에는 딱히 새로운 방법이 아니라, 이미 잘 알려진 truncated SVD를 사용하면 된다. 이에 대해서는 예전에 작성한 글을 참고하면 된다.
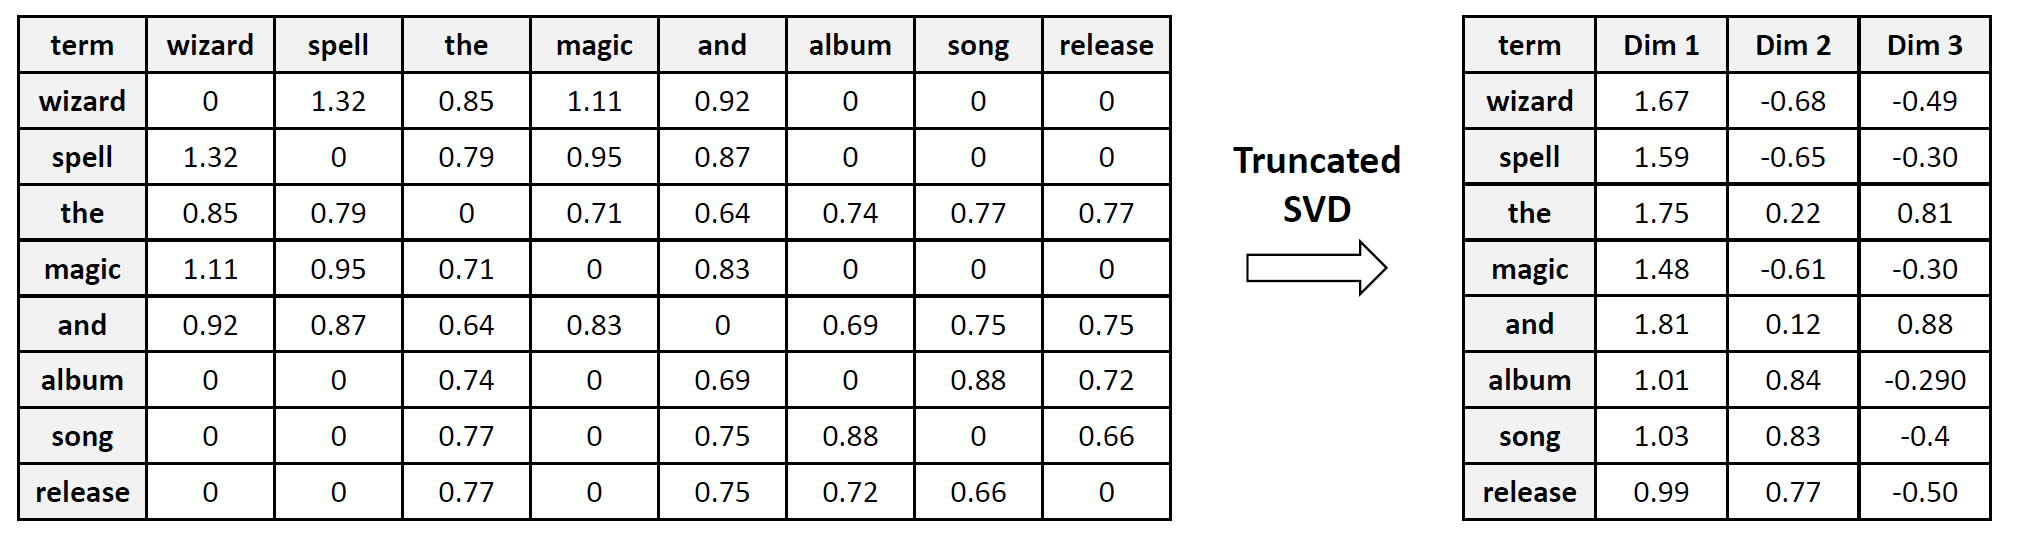
위 두 과정을 통해 처음에 제시되었던 예시 상황의 matrix를 Dense Representation으로 바꾼 결과는 위 사진과 같다.
2. Skip-gram Learning
두번째 방법은 Skip-gram Learning이다. 이는 위의 차원축소보다 좀 더 ML에 가까운 방법으로, Word2Vec으로도 알려진 접근법이다.
아이디어는 간단한데, 위에서 구성했던 Word-word co-occurrence matrix는 결국 Context word와 Center word가 주어진 데이터이다. 즉, 이 데이터셋을 그대로 활용해서 Center word로부터 Context word를 예측하는 모델을 학습시켜보자는 것이다. 이것을 예측할 수 있다는 이야기는, 특정 단어가 주어졌을 때 같이 나오는 단어들, 즉 Context를 이해할 수 있다는 의미이고, 이는 다시 Distributional Hypothesis에 의해 유사한 맥락에서 나올 수 있는 다른 단어까지 예측이 가능하다는 의미가 된다.
그러면 이 모델을 학습시키기 위한 Objective function은 어떻게 될까? 우리의 목적은 Center word $w$가 주어졌을 때 Context word $c$를 예측하는 것이다. 따라서 $D$를 전체 co-occurrence pairs의 집합이라고 하면, 우선 다음과 같이 생각해볼 수 있다.
\[\max_\theta \sum_{(w,c)\in\mathcal{D}}p_\theta(c\vert w)\]그러면 전체 데이터셋, 즉 Embedding table이 주어졌을 때 각각의 확률 $p_\theta(c\vert w)$를 어떻게 정의할 수 있을까? 여기서 한 가지 트릭이 사용된다. Center word embedding table과 Context word embedding table을 따로 두고, 각각의 table에서의 vector를 각각 $v_w$, $v_c$라고 하면, 다음과 같이 각 쌍의 log probability가 각 벡터의 내적에 비례한다고 가정할 수 있다.
\[\log p_\theta(c\vert w)\propto v_c\cdot v_w\]따라서 다음과 같이 Softmax로 계산이 가능하다.
\[p_\theta(c\vert w)=\dfrac{\exp(v_c\cdot v_w)}{\sum_{c^{\prime}\in\mathcal{V}}\exp(v_{c^{\prime}}\cdot v_w)}\]이를 최적화 문제로 바꾸기 위해서, 늘 그렇듯이 다음과 같이 negative log를 취해서 이를 Loss function으로 삼아 Gradient Descent 등으로 학습시키면 된다.
\[\begin{aligned} \min_\theta \mathcal{L}(\theta)&=-\sum_{(w,c)\in\mathcal{D}}\log p_\theta(c\vert w) \\ &= -\sum_{(w,c)\in D}\left(v_c\cdot v_w-\log\sum_{c^{\prime}\in\mathcal{V}}\exp(v_{c^{\prime}}\cdot v_w)\right) \end{aligned}\]그런데 위의 Loss function은 사실 상당히 비효율적이다. 이는 특정 단어가 항상 붙어나오는 Positive한 관계에 비해, 단어 사이의 관계가 거의 없는 Negative한 관계는 무수히 많아 이를 모두 계산하는 것은 연산량이 너무 많기 때문이다. 이를 해결하기 위해 이 Negative 관계의 단어는 일부만 Sampling해서 계산한다. 이를 Negative Sampling이라고 부른다.
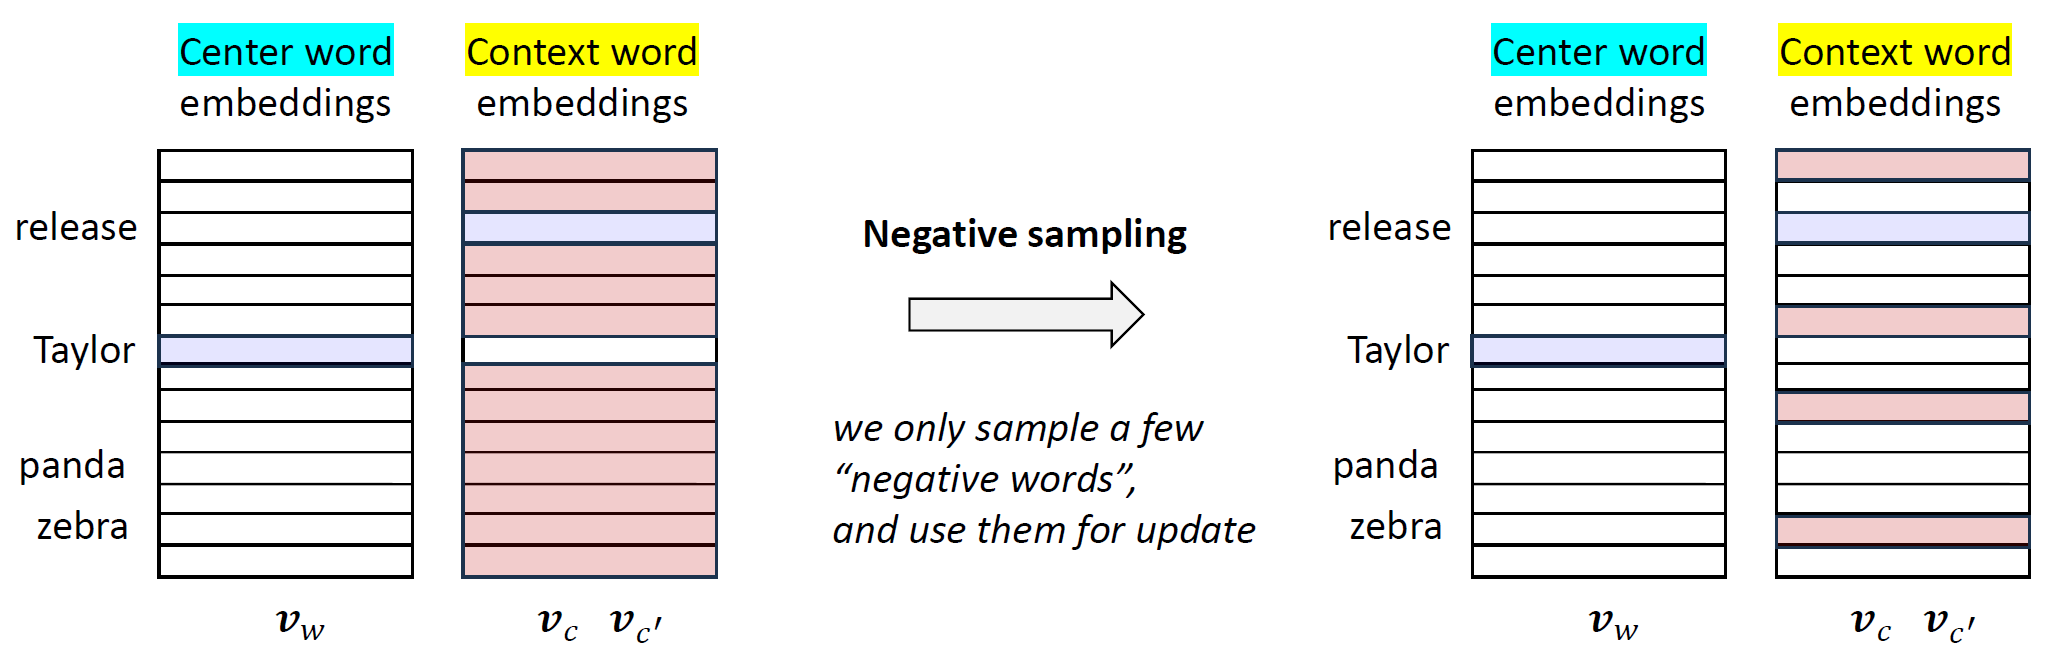
이 때, 이 Negative Sampling은 일반적으로 epoch마다, 혹은 batch마다 새롭게 진행한다. 당연히 학습 내내 똑같은 Negative pair만 주면 좋은 학습이 되지 않기 때문이다.
그리고 전체 Vocabulary space에 대한 모든 Negative pair를 고려하지 않고, Negative Sampling을 통해 일부만 고려하도록 바꿨으므로, 이에 따라 Loss function도 바뀌어야 한다. 이는 원래 Loss function에서 사용했던 Softmax는 전체 Vocabulary space에 대한 Normalization을 상정하고 사용된 함수이기 때문이다.
그래서 Task 또한 조금 쉬운 버전으로, 즉 binary classification 문제로 바꾼다. 이 경우 특정 Pair 하나를 보고, 이게 True pair인지 아닌지만 판단하는 문제가 된다. Binary classification 문제로 바뀌었으므로, 더 이상 softmax를 사용하지 않고 sigmoid를 사용하게 된다.
\[p_\theta(\text{True}\vert c,w)=\sigma(v_c\cdot v_w)=\dfrac{1}{1+\exp(-v_c\cdot v_w)}\]즉, 최종적인 Loss function은 다음과 같다.
\[\min_\theta\mathcal{L}(\theta)=-\sum_{(w,c)\in\mathcal{D}}\left(\log\sigma(v_c\cdot v_w)+\sum_{c^{\prime}\in\mathcal{N}}\log\sigma(-v_{c^{\prime}}\cdot v_w)\right)\]여기서 $\mathcal{N}$은 무작위로 sampling된 Negative set이며, 일반적으로 5~10 정도의 크기로 잡는다.
Equivalence
재밌는 점은, 이들 두 방식이 사실 같은 대상을 근사한다. 물론 완벽하게 동일한 계산을 한다는 의미는 아니고, Negative sampling을 적용한 Skip-gram (SGNS, Skip-gram with Negative sampling)의 Loss function을 통해 최적화된 결과가 PMI를 계산한 matrix와 동일하다는 이야기이다.
어째서 그렇게 될까? 이를 위해 SGNS의 Loss function을 다시 살펴보자.
\[\mathcal{L}(\theta)=-\sum_{(w,c)\in\mathcal{D}}\left(\log\sigma(v_c\cdot v_w)+\sum_{c^{\prime}\in\mathcal{N}}\log\sigma(-v_{c^{\prime}}\cdot v_w)\right)\]여기서 Negative pair를 다루는 두 번째 항부터 먼저 정리하자. 위의 항은 특정한 sampling 한번으로 얻어지는 결과이다. 그런데 최적화를 끝낸 이후라면, 특정 한 번의 Negative sampling이 아니라 전체 결과를 따져봐야 한다. 따라서, 이 항은 다음과 같이 기댓값 형태로 표현해야 한다.
\[\mathbb{E}\left[\sum_{c^{\prime}\in\mathcal{N}}\log\sigma(-v_{c^{\prime}}\cdot v_w)\right]\]이 Negative sample의 집합의 크기를 $k$라고 하면, $\mathcal{N}$의 원소들이 $P_n$에서 iid로 뽑히고, 또 크기가 $k$니까 이 항은 다음과 같이 바꿀 수 있다.
\[\mathbb{E}\left[\sum_{c^{\prime}\in\mathcal{N}}\log\sigma(-v_{c^{\prime}}\cdot v_w)\right]=k\cdot\mathbb{E}_{c_\mathcal{N}\sim P_n}\left[\log\sigma(-v_{c^\mathcal{N}}\cdot v_w)\right]\]따라서 수정된 Objective function은 다음과 같다.
\[\mathcal{L}(\theta)=\sum_{(w,c)\in\mathcal{D}}\left(\log\sigma(v_c\cdot v_w)+k\mathbb{E}_{c_\mathcal{N}\sim P_n}\left[\log\sigma(-v_{c^\mathcal{N}}\cdot v_w)\right]\right)\]여기서 Positive pair를 다루는 첫 번째 항에서 정의하는 집합 $\mathcal{D}$는 중복이 허용된다. 즉, 동일한 $(w,c)$ pair가 여러 번 등장할 수 있고, 그 등장 횟수는 정확히 $\text{count}(w,c)$이다. 따라서 저 항은 다음과 같이 바꿀 수 있다.
\[\sum_{(w,c)\in\mathcal{D}}\log\sigma(v_c\cdot v_w)=\sum_{w\in V_w}\sum_{c\in V_c}\text{count}(w,c)\log\sigma(v_c\cdot v_w)\]이제 두 번째 항도 다시 살펴보자. 여기서는 기댓값으로 인해 $c$를 Marginalize한다. 따라서 $w$에만 의존하므로 우선 다음과 같이 바꿀 수 있다.
\[\sum_{(w,c)\in\mathcal{D}}k\mathbb{E}_{c_\mathcal{N}\sim P_n}\left[\log\sigma(-v_{c^\mathcal{N}}\cdot v_w)\right]=\sum_w\text{count}(w)\cdot k\mathbb{E}_{c_\mathcal{N}\sim P_n}\left[\log\sigma(-v_{c^\mathcal{N}}\cdot v_w)\right]\]그런데 $\text{count}(w)=\sum_c\text{count}(w,c)$이다. 또한 특정한 $(w,c)$ pair에 대해서만 확인하기 위해 기댓값을 $P_\mathcal{D}(c_\mathcal{N})=\text{count}(c_\mathcal{N})/\vert\mathcal{D}\vert$로 풀어보면, $(w,c)$에 대한 Objective function은 다음과 같다.
\[\mathcal{L}(w,c)=\text{count}(w,c)\log\sigma(x)+k\cdot\text{count}(w)\dfrac{\text{count}(c)}{\vert\mathcal{D}\vert}\log\sigma(-x),\quad x=v_c\cdot v_w\]여기서, $x=v_c\cdot v_w$를 자유 변수로 Reparameterization할 수 있다. 이는 차원 $d$가 충분히 크면 $WC^T$로 임의의 matrix를 만들 수 있어 각각의 $x_{wc}$를 독립적으로 최적화할 수 있기 때문이다.
SGNS의 학습 결과는 이 함수를 Objective function으로 삼으므로, Gradient Descent에 의해 위의 함수를 미분하면 그 값이 0이 나오게 될 것이다. 그 경우 다음과 같다.
\[\text{count}(w,c)\sigma(-x)=k\cdot\text{count}(w)\dfrac{\text{count}(c)}{\vert\mathcal{D}\vert}\sigma(x)\]여기서 $\sigma(-x)/\sigma(x)=e^{-x}$이므로, 다음과 같다.
\[e^{-x}=\dfrac{k\cdot\text{count}(w)\text{count}(c)}{\vert\mathcal{D}\vert\text{count}(w,c)}\] \[x=\log\dfrac{\vert\mathcal{D}\vert\text{count}(w,c)}{\text{count}(w)\text{count}(c)}-\log k=\text{PMI}(w,c)-\log k\]즉, 차원 축소 쪽 방법에서 실제로 SVD를 하기 전의 값인 PMI matrix를 따라간다는 것을 알 수 있다. 따라서 이 두 방법이 사실상 같은 결과를 내는 것이 목적임을 알 수 있다.
Similarity
Sparse Representation에서는 Inner product가 그리 좋은 지표가 아니라 대신 Cosine similarity를 사용했었다. 그렇다면 Dense Representation에서는 어떨까?
여기서는 다시 Inner product가 좋은 지표가 된다. 이는 Dense Representation은 단순한 counting 기반의 vector가 아니기 때문에 정규화를 시킬 수 있기 때문이다.
즉, Sparse Representation에서 Inner product가 좋지 않았던 가장 큰 이유인, “vector의 길이 자체가 유사도에 영향을 미친다”는 문제가 애초에 발생하지 않기 때문에, 다시 Inner product를 사용해도 되는 것이라고 볼 수 있다.